김홍연 (Kim H.Y.)
차명훈 (Cha M.H.)
강기동 (Kang K.D.)
박경서 (Park G.S.)
석성우 (Sok S.W.)
이은경 (Lee E.G.)
김진미 (Kim J.M.)
고광원 (Koh K.W.)
I. 서론
생성형 AI가 확산하면서 인프라의 무게중심이 학습에서 추론으로 이동하고 있다. 추론 워크로드는 요청이 불규칙하게 몰리고 입력과 출력의 길이가 매번 달라, 정적인 자원 배분으로 대응하기 어려운 특성을 갖는다[1]. 여기에 전력과 비용이 인프라 설계의 지배적 제약으로 부상하면서, 단일 종류의 가속기를 대량으로 투입하는 방식만으로 효율을 확보하기는 어려워졌다. 추론 서비스의 효율화를 다룬 최근 조사들도 연산‧메모리‧통신 자원을 함께 조율하는 방향을 공통으로 지목한다[2].
이러한 배경에서 가속 장치의 종류가 다양해졌다. NPU는 추론 연산의 전력 효율을, PIM은 메모리 대역폭 병목을, CXL 메모리는 용량 확장과 풀링을, DPU는 데이터 경로의 부하를 각각 겨냥한다. 국내에서도 이들 장치를 데이터센터에 단계적으로 적용하는 사업이 추진되어 왔으며[3], 최근에는 국산 장치를 기존 생태계와 혼성 구성하는 방향이 정책 차원에서도 전제되고 있다.
그러나 이 장치들을 함께 운용하는 일은 하드웨어를 확보하는 일과는 별개의 문제다. 클러스터 자원관리 소프트웨어는 대체로 동질 자원, 구체적으로는 단일 GPU 생태계를 전제로 설계되어 왔다. 최근 스케줄링 연구를 정리한 조사는 기본 스케줄러가 서로 다른 가속기가 섞인 워크로드를 다루기 어렵고, GPU 이외 장치의 공유‧가상화 연구가 제한적임을 지적한다[4]. 이종 장치의 성능 이득이 개별적으로 실증되어 있음에도 그 이득을 서비스 수준에서 실현하기 어려운 사정이 여기에 있다.
본고는 이 문제를 자원관리 계층의 관점에서 정리한다. 장치의 회로 설계나 모델 자체의 최적화는 범위에서 제외하고, 장치를 자원으로 표현하고 할당하며 그 위에서 작업을 배치하는 계층에 초점을 둔다. 국산 AI 반도체를 중심에 두되, 비교와 맥락을 위해 국외 연구와 오픈소스 프로젝트를 함께 검토하였다.
구성은 다음과 같다. Ⅱ장에서 이종 인프라의 구성과 자원관리 요구사항을 정리하고 국산 장치를 자원관리 인터페이스 기준으로 비교한다. Ⅲ장에서 추상화‧런타임, 자원 할당‧스케줄링, 메모리‧데이터 중심 관리, 대규모 추론 서비스와의 결합, 관측성‧전력 인지 최적화의 다섯 축으로 연구 동향을 검토한다. Ⅳ장에서 국내외 추진 현황과 표준화 동향을, Ⅴ장에서 시사점과 향후 연구 방향을 논의하고, Ⅵ장에서 결론을 맺는다.
II. 이종 AI 반도체 인프라와 자원관리 요구사항
1. 장치별 역할과 자원관리 관점의 차이
AI 컴퓨팅 인프라를 구성하는 가속 장치는 연산 가속기 일변도에서 벗어나고 있다. NPU(Neural Processing Unit)는 추론 연산의 전력 효율을 겨냥하고, PIM(Processing-In-Memory)은 메모리 대역폭 병목을, CXL(Compute Express Link) 메모리는 용량 확장과 풀링을, DPU(Data Processing Unit)는 데이터 경로의 CPU 부하를 각각 담당한다. 장치별 역할 분담 자체는 비교적 명확한 편이다.
그러나 자원관리 관점에서 보다 근본적인 어려움은 역할 분담이 아니라, 각 장치가 관리 가능한 자원으로 표현되는 방식이 서로 다르다는 점이다. NPU는 GPU와 마찬가지로 개수를 셀 수 있는 독립 장치로 표현된다.
반면, PIM은 독립 장치가 아니라 메모리에 부속된 연산 능력이므로 할당 단위 자체가 모호하며, 실제 활용 여부는 연산자 매핑 결정에 종속되는 경향이 있다. CXL 메모리는 장치가 아니라 주소 공간으로 노출되어 기존 NUMA 추상화에 흡수된다. DPU는 워크로드가 요청하는 자원이 아니라 데이터 경로에 삽입되는 기능에 가까워 자원 요청 모델 안에 표현할 자리를 찾기 어렵다.
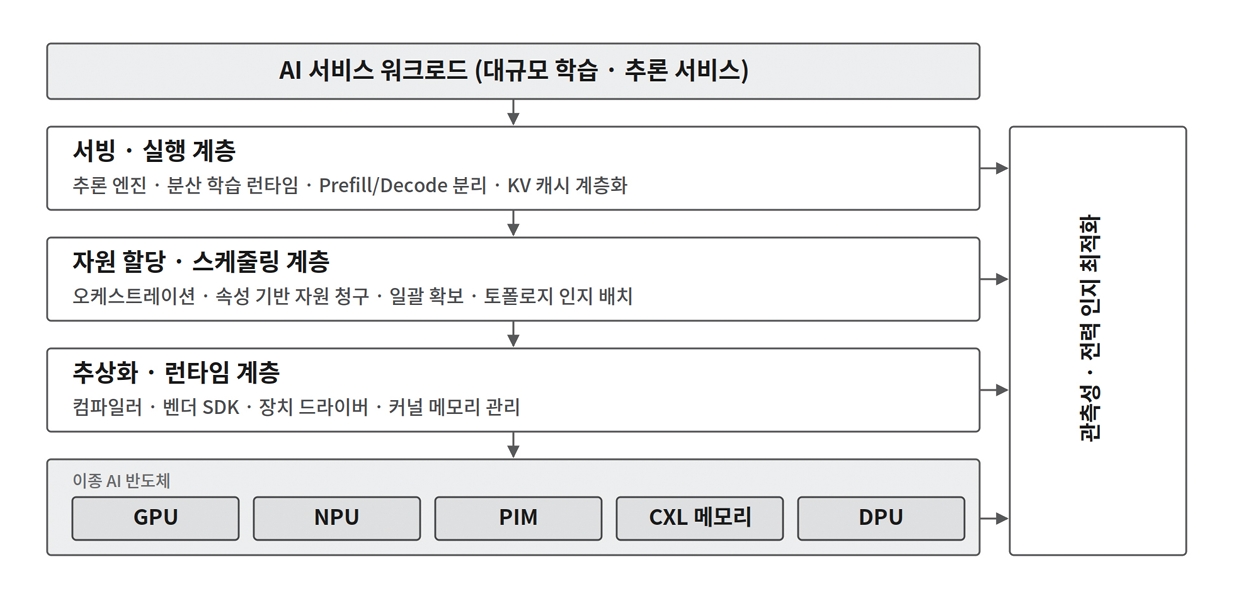
이렇게 보면 ‘이종성(Heterogeneity)’이 초래하는 난점은 장치 간 성능 차이보다는 자원 개념 자체의 불일치에 가깝다고 할 수 있다. 그림 1은 이 논의의 대상이 되는 계층 구조를 정리한 것으로, 이후 Ⅲ장의 서술 순서도 이 계층에 대응한다.
2. 국산 AI 반도체의 자원관리 인터페이스 현황
표 1은 국산 AI 반도체를 자원관리 인터페이스 관점에서 정리한 것이다. 장치의 연산 성능이나 전력 효율은 비교 대상에서 제외하고, 자원으로서 관리되기 위해 필요한 항목만을 열로 삼았다.
표 1 국산 AI 반도체 유형별 자원관리 인터페이스 현황
NPU 영역의 성숙도는 낮다고 보기 어렵다. 퓨리오사AI RNGD는 SR-IOV를 통해 단일 칩을 2‧4‧8개의 독립 NPU 인스턴스로 분할하며, 각 인스턴스는 전용 연산 코어와 사설 메모리 대역폭으로 하드웨어 격리되어 상호 배치된 워크로드에 결정적 지연을 보장한다[5]. 리벨리온의 RBLN SDK는 드라이버‧컴파일러‧런타임에서 프로파 일링, 서빙, 쿠버네티스 기반 클라우드 네이티브 배포까지를 포괄하며, NPU Operator, Device Plugin, NPU Feature Discovery, Metrics Exporter와 함께 DRA 드라이버를 함께 제공하고 있다[6]. 장치 차원에서도 멀티테넌시(Multi-tenancy)가 고려되는 흐름이 나타난다. 리벨리온이 ISSCC 2026에서 발표한 쿼드 칩렛 구조는 특정 태스크가 다른 태스크를 기아 상태로 만들지 않도록 태스크 수준 QoS를 구현해 롱테일 지연을 줄이고 혼재 워크로드의 혼잡을 완화한다[7].
반면 메모리‧데이터 경로 장치로 내려가면 오케스트레이션 지원 수준은 현격히 낮아진다. CXL의 경우 소프트웨어 계층은 상당 부분 확보되어 있다. SK하이닉스의 HMSDK는 CXL 메모리 지원을 목적으로 설계된 개방형 개발 키트이며, 가중 인터리빙과 DAMON 기반 계층 메모리 관리 등 커널 기능이 메인라인 리눅스에 반영되었다[8]. 삼성전자 역시 CXL 연결 메모리를 가상화하는 SMDK를 공개하였다[9]. 다만 이들은 모두 커널‧NUMA 계층의 기술이며, 클러스터 자원관리 계층에서 CXL 메모리를 독립 자원으로 요청‧할당하는 모델은 아직 충분히 마련되어 있지 않다. DPU는 이보다 더한 편으로, NVMe/TCP 스택 전체를 하드웨어로 오프로드하고 GPU 메모리와 원격 스토리지 간 직접 전송으로 CPU를 우회하는 방식으로 효과를 내지만[11], 그 효과는 자원 할당의 결과라기보다 인프라 구성의 결과에 가깝다.
여기서 확인되는 것은 국내 장치의 개별 성숙도가 부족하지는 않다는 것이다. 벤더별로 각자 완결된 관리 스택이 형성되고 있으며, 그 스택들을 가로지르는 공통 표현이 아직 없다는 점이 실질적인 공백에 해당한다고 보는 편이 적절하다.
3. 이종 통합이 유발하는 난제
• 자원 표현의 이질성: 장치별로 할당 단위‧속성‧격리 방식이 달라 단일 자원 모델로 기술하기 어렵다.
• 성능 비대칭: 다세대‧다종 장치가 혼재하면 동일 작업을 균등 분배하는 정책이 저성능 장치의 병목과 고성능 장치의 유휴를 동시에 유발할 수 있다.
• 메모리 계층 분산: HBM, 로컬 DRAM, CXL 확장 메모리, PIM 내부 대역폭이 서로 다른 접근 특성을 가지며, 어느 계층에 어떤 데이터를 두는지가 성능을 크게 좌우한다.
• 토폴로지 의존성: 칩렛 내부 메시, 카드 간 인터커넥트, 노드 간 패브릭의 계층이 깊어져 배치 위치가 성능에 미치는 영향이 커졌다.
• 관측 지표 단절: 장치마다 노출 지표의 종류와 의미가 다르다. 다중 벤더 가속기를 함께 모니터링하는 오픈소스 도구는 퓨리오사 NPU의 코어별 PE 사용률과 전력 거버너 모드, 리벨리온 NPU의 성능 상태와 KMD 버전, Gaudi의 AIP 사용률처럼 서로 다른 지표군을 개별적으로 처리한다[12]. 실제로 이 도구는 비NVIDIA NPU 익스포터 전반에 대해 라벨 이름을 npu_index‧npu_uuid로 분리하는 비호환 변경을 도입한 바 있다[12]. 이종 지표를 담을 공통 스키마가 마련되어 있지 않다는 사정이 구현 수준에서 드러난 사례로 볼 수 있다.
• 제어 평면과 데이터 평면의 시간 척도 불일치: 자원 할당 제어는 밀리초 단위로 동작하지만, 가속기가 실제로 서비스 가능한 상태가 되기까지는 가중치 적재와 실행 상태 준비에 수십 초 이상이 소요된다. 이 격차는 동적 자원관리의 실효성을 제약하는 요인으로, Ⅴ장 2절에서 다룬다.
4. 평가 지표 동향
이종 환경의 자원관리 효과를 측정하는 지표는 대체로 네 축으로 수렴한다. 연산 자원의 활용도는 이론 최대 성능 대비 실제 달성 성능의 비율인 MFU(Model FLOPs Utilization)로[13], 에너지 효율은 단위 전력당 연산 성능으로 표현된다. 서비스 품질은 추론 지연의 99분위 값을 기준으로 하며[14], 특히 디코딩 단계의 토큰당 출력 시간(TPOT)에 대한 SLO 달성률이 널리 쓰인다. 마지막으로 자원관리 자체가 유발하는 오버헤드가 지표로 다루어진다.
그러나 이종 환경에서는 이 지표들의 비교 가능성이 상당 부분 약해진다. MFU는 이론 최대 성능을 분모로 삼으므로 장치마다 기준이 달라지고, 전력 효율은 정밀도 형식에 따라 크게 변한다. 관리 오버헤드 역시 규모에 따라 타협되는 값이다. 앞서 언급한 모니터링 도구는 관리 노드 수에 따라 수집 주기를 1~10노드 3초, 51~100노드 5초, 101노드 이상 6초로 적응적으로 늘린다[12]. 즉 오버헤드는 고정된 특성이라기보다 관측 해상도와의 교환 관계에서 결정되는 설계 변수로 볼 수 있다. 이 비교 가능성의 문제는 Ⅴ장 3절에서 다시 논의한다.
III. 통합 자원관리 핵심 기술 동향
1. 이종 가속기 추상화 및 런타임 계층
이종 장치를 하나의 인프라에서 다루기 위한 첫 관문은 실행 계층의 추상화다. 여기서 마주치는 것은 단순한 API 차이가 아니라 실행 모델 자체의 차이에 가깝다. GPU 생태계는 즉시 실행과 실행 시점 커널 선택을 전제로 발전해 왔지만, 국내 NPU는 대체로 사전 컴파일(AOT: Ahead Of Time) 모델을 채택한다. 리벨리온의 RBLN SDK는 사전 학습 모델을 컴파일러로 변환한 뒤 런타임 API로 추론하고 프로파일러로 분석하는 흐름을 전제로 하며, 드라이버‧컴파일러‧런타임‧프로파일러‧서빙 프레임워크를 하나의 스택으로 제공한다[6]. 컴파일 산출물이 실행 단위가 되므로, 모델이 바뀌거나 입력 형상이 달라지면 준비 과정이 다시 필요하다.
추상화를 어느 계층에서 시도하는지에 따라 접근이 갈린다. 프레임워크 계층에서는 기존 학습 프레임워크의 코드를 그대로 받아들이는 방향이 주류다. RBLN SDK는 PyTorch‧TensorFlow‧Hugging-Face 모델을 지원하고, HuggingFace 생태계에 대응하는 별도 계층과 vLLM 연동을 함께 제공한다[6]. 퓨리오사AI 역시 유사한 구성을 취한다[5]. 이 계층의 추상화는 이식 비용을 낮추는 데 효과적이지만, 장치별 특수 기능이나 사용자 정의 연산이 필요한 지점에서는 다시 벤더 고유 경로로 내려가게 된다. 실제로 RBLN SDK는 Triton 기반 사용자 정의 커널 작성 경로를 별도로 두고 있다[6].
중간표현(IR: Intermediate Representation) 계층에서는 OpenXLA‧StableHLO나 Triton처럼 공통 표현을 두어 백엔드 다양성을 흡수하려는 시도가 이어지고 있다. 다만 이 방향은 연산 표현의 공통화에 초점이 있어, 장치별 메모리 계층이나 병렬 구조의 차이를 완전히 감추기는 어려운 편이다.
플랫폼 계층의 접근도 존재한다. 모레의 MoAI 플랫폼은 AMD GPU 환경의 커널‧라이브러리 최적화와 함께 GPU‧NPU를 가상화해 단일 논리 클러스터로 운영하는 방식을 취하며, 특정 벤더에 종속되지 않는 것을 설계 원칙으로 삼는다[15]. 단일 장치 추상화와 자동 병렬화를 통해 사용자가 하나의 큰 장치를 대상으로 작성한 코드를 다수 가속기에 분산하는 구조다. 운영 편의는 높아지지만, 종속의 대상이 장치 벤더에서 플랫폼 제공자로 이동한다는 성격도 함께 갖는다.
자원관리 관점에서 이 계층들을 관통하는 공통점을 하나 짚어둘 필요가 있다. 위 접근들은 모두 실행을 추상화하지만 자원 표현을 추상화하지는 않는다. 코드가 여러 장치에서 동작하게 만드는 일과, 클러스터 스케줄러가 그 장치들을 동일한 자원 모델로 기술하고 배치를 결정하는 일은 별개의 문제다.
2. 자원 인지 스케줄링과 오케스트레이션
컨테이너 오케스트레이션은 AI 인프라의 사실상 표준 제어 평면으로 자리 잡았으나, 그 스케줄링 모델은 본래 동질 자원을 상정하고 설계되었다. 2023년 이후 스케줄링 연구를 정리한 최근 조사에 따르면, 기본 스케줄러는 CPU와 서로 다른 가속기가 섞인 워크로드를 오케스트레이션하는 데 어려움을 겪으며, GPU 공유에 관한 연구는 풍부한 반면, NPU‧FPGA를 다룬 연구는 제한적이고 그 밖의 가속기 가상화는 거의 다루어지지 않았다[4]. 또한, 다수 스케줄러가 단일 자원 차원에 집중해 CPU‧메모리‧가속기 사이의 상호 제약을 간과하는 경향이 있어, 노드의 총량은 충분하지만 필요한 조합이 동시에 확보되지 않아 작업을 시작할 수 없는 상황이 발생하며, 작업 수명주기가 비동기적으로 흐르면서 자원 단편화가 심화된다[4].
이 문제의 구조적 원인 중 하나는 장치를 정수 개수로만 요청하던 관행이었다. 요청 측은 ‘가속기 한 개’를 말할 수 있을 뿐, 어떤 세대의 장치인지, 메모리가 얼마인지, 어느 토폴로지에 놓이는지를 표현할 수단이 없었다. 동적 자원 할당(DRA: Dynamic Resource Allocation)은 워크로드가 필요한 하드웨어를 메모리‧장치 계열‧성능 등급 같은 속성으로 기술하고 스케줄러가 그 요구를 가용 하드웨어에 대응시키는 방식으로 이 지점을 바꾸었으며, 핵심 기능이 쿠버네티스 1.34에서 정식 기능이 되고 1.35에서는 기본 활성화되었다[16]. DeviceClass‧Resource-Claim‧ResourceClaimTemplate‧ResourceSlice가 동일 API 그룹에 편입되면서, 불투명한 개수 요청에서 속성 기반 청구로 이동한 것이 이 변화의 요지다[16]. 생태계 차원의 이동도 함께 진행되었다. 2026년 KubeCon Europe에서 NVIDIA가 자사 DRA 드라이버를 CNCF에 기부했고, DRA는 KAI Scheduler‧Grove와 결합해 2017년부터 쓰이던 장치 플러그인 모델을 대체하는 구도가 되었다[17]. 앞서 살펴본 것처럼 국내 NPU 벤더도 이 흐름에 대응하는 드라이버를 함께 제공하고 있다[6].
배치 정책 계층에서는 작업 단위의 특성을 반영하는 방향이 정리되어 왔다. 분산 학습‧추론은 다수 파드가 동시에 확보되어야 의미가 있으므로 일괄 확보(gang) 의미론이 필요하고, 장치 간 통신 비용이 성능을 좌우하므로 토폴로지를 고려한 배치가 요구된다. Grove는 계층적 gang 스케줄링, 토폴로지 인지 배치, 다단 자동 확장, 시작 순서 제어를 제공하며 DRA 및 KAI Scheduler의 gang 스케줄링 계층과 연동되도록 설계되었다[18]. 이종 장치 간 성능 비대칭을 정책에 반영하는 시도는 학습 클러스터 스케줄러 계보에서 먼저 정리된 편으로, 장치별 처리 속도 차이를 고려해 작업을 배분하거나[19] 유효 처리량을 목적함수로 삼는[20] 접근이 대표적이다.
자원 확보 범위를 단일 클러스터 밖으로 넓히는 그리드‧페더레이션도 축의 하나다. 국내 사례로는 110개 이상 사이트에서 16,000개 이상 가속기를 관리하며 11종 이상의 이종 아키텍처를 지원하는 플랫폼이 있다[21]. 이 플랫폼의 오케스트레이터는 분할 단위의 자원 분배와 함께 스케줄링 결정 시점에 세션을 동적으로 생성‧삭제하며 자원을 즉시 할당‧회수하는 구조를 취한다[21]. 다만 자원 가용 범위가 넓어질수록 데이터와 모델의 지역성 문제가 커진다는 점에서, 확장성과 지역성은 상충하는 축으로 다루어질 필요가 있다.
여기서 확인할 사항은 DRA는 자원 청구의 표현력을 크게 개선했지만, 그것이 곧 실서비스에서의 동적 자원 운용으로 이어진다고 보기는 어렵다는 점이다. 가속기는 할당만으로 사용 가능한 상태가 되지 않고, 장치 메모리에 대규모 가중치를 올리고 실행 상태를 준비하는 과정을 거쳐야 한다. 한 서버리스 사업자의 관찰에 따르면 컨테이너 이미지 확보는 이미 병목이 아니며, 실제 비용은 그 이후의 초기화 경로―모듈 임포트, 프레임워크 적재, 가중치 조립과 장치 메모리 복사, 컴파일과 그래프 캡처, KV 캐시 초기화―에 놓여 있다[22]. 그 결과 운영 현장에서는 사용자 대면 엔드포인트에 최소 복제본을 상시 예열 상태로 유지해 유휴 비용과 콜드스타트 지연을 맞바꾸고, 영점까지 축소하는 구성은 개발‧스테이징에 한정하는 방식이 권고되기도 한다[22]. 이는 기능적 지원과 실용적 활용 사이의 간격을 보여주는 사례로, Ⅴ장 2절에서 논의한다.
3. 메모리·데이터 중심 자원관리
연산 장치의 성능이 빠르게 오르는 동안 메모리 대역폭과 용량이 상대적 제약으로 부상했고, 이에 대응하는 장치들이 등장했다. 이 장치들의 공통점은 연산을 데이터에 가깝게 옮기거나, 데이터 이동 자체를 전담 하드웨어로 넘긴다는 점이다.
PIM 계열의 접근은 추론 연산의 부하 분포에서 출발한다. 디코딩 단계는 행렬-벡터 연산이 지배적 이어서 연산 강도가 낮고 메모리 대역폭에 묶이므로, 뱅크 수준 병렬성을 활용할 수 있는 메모리 내부 연산이 유리해진다. SK하이닉스는 추론 과정의 80~90%를 차지하는 어텐션 연산을 전담 가속하는 GDDR6-AiM 구조를 통해 내부 대역폭을 16배 확보하고 에너지 효율을 약 4배 개선했으며, 검증되지 않은 메모리를 위해 메인 컨트롤러를 쉽게 바꾸지 않는 고객사의 진입 장벽을 고려해 PCIe 카드 형태의 가속기 인프라를 직접 제작해 성능을 입증해 왔다[23]. 국내 연구도 이 지점에 집중되어 왔다. AttAcc은 배치 추론에서 PIM을 어텐션 가속에 활용하는 구조를[24], NeuPIMs는 NPU와 PIM을 결합한 이종 가속 구조를[25], IANUS는 NPU와 PIM이 메모리를 공유하는 통합 시스템을[26] 각각 제시했다. Duplex는 전문가 혼합 구조와 그룹 질의 어텐션, 연속 배칭을 함께 고려한 장치 설계를 다루었고[27], CXL 인터페이스에 연산 기능을 결합해 총소유비용을 겨냥한 플랫폼도 제시되었다[28]. 이들은 대체로 행렬-행렬 연산은 호스트 연산기가, 행렬-벡터 연산은 PIM이 담당하는 역할 분담과 그 사이의 연산자 매핑‧스케줄링에 초점을 둔다. 즉 PIM의 활용도는 장치를 확보했는지보다 연산 그래프를 어떻게 분할했는지에 좌우되는 성격을 갖는다.
CXL 장치는 용량과 풀링을 겨냥한다. 초기 연구는 원격 메모리 직접 접근의 실효성을 확인하는 데 무게가 있었고[29], 이후 클라우드 환경의 메모리 풀링 설계로 확장되었다[30]. 배치 정책 쪽은 접근 빈도에 따라 페이지를 이동시키는 방향으로 정리되었으며, 국내에서도 페이지 분류와 크기 결정을 동적으로 수행하는 계층화 기법이 제시되었다[31]. 상용 소프트웨어 계층도 확보된 편이다. HMSDK는 기존 메모리와 확장 CXL 메모리 사이의 대역폭에 따라 메모리를 선택적으로 할당해 애플리케이션 수정 없이 대역폭을 30% 이상 개선하고, 접근 빈도 기반 재배치로 12% 이상의 성능 향상을 함께 제공한다[10]. 가중 인터리빙과 DAMON 기반 계층 메모리 관리 등 관련 커널 기능은 메인라인 리눅스에 반영되었다[8].
DPU 계열은 자원이 아니라 경로를 다룬다. NVMe/TCP 스택 전체를 하드웨어로 오프로드해 CPU 소모 없이 전이 중 라인레이트를 확보하고, GPU 메모리와 로컬‧원격 스토리지 사이의 직접 전송으로 CPU를 우회하는 방식이 대표적이다. 국내 사례에서는 3D-UNet 워크로드 기준 대안 대비 GPU 확장성 6.2배, 400G 대역폭당 처리량 1.57~2.05배와 함께 경쟁 DPU 대비 우수한 성능 대비 비용이 보고되었다[11].
세 계열을 함께 놓고 보면 하나의 공통 양상이 드러난다. 성능 이득은 실증되어 있으나, 그 이득을 얻을지 여부가 자원 할당의 결정이 아니라 시스템 구성이나 연산 그래프 분할의 결정에 달려 있다. PIM의 활용 여부는 컴파일‧매핑 단계에서, CXL의 계층 배치는 커널 정책에서, DPU의 효과는 서버 구성에서 결정된다. 클러스터 자원관리 계층이 ‘이 작업에 CXL 확장 메모리 200GB와 어텐션 오프로딩 경로를 함께 배정한다’라고 기술할 표현 수단은 아직 마련되어 있지 않다. 뒤에서 살펴볼 표 2의 가운데 행이 오른쪽으로 갈수록 비는 것이 이 상황을 요약한다.
표 2 자원관리 계층 × 관리 대상 자원에 따른 기술 분포
4. 대규모 추론 서비스와의 결합
자원관리와 추론 서비스는 오랫동안 별개 계층으로 다루어졌으나, 최근에는 서빙 구조의 변화가 자원 배치 방식을 직접 규정하는 방향으로 가고 있다. 출발점은 요청 단위 배칭의 한계를 넘어선 Orca의 반복 단위 스케줄링과[33] vLLM이 도입한 페이지 단위 KV 캐시 관리였다[34]. 이어 Sarathi-Serve가 프리필과 디코딩을 함께 배칭할 때 발생하는 처리량-지연 상충을 다루었다[35].
전환점은 두 단계를 완전히 분리하는 접근이다. 프리필은 입력 전체를 한 번에 처리해 연산 집약적이고, 디코딩은 토큰마다 KV 캐시를 읽어 메모리 대역폭에 묶인다. 두 단계를 한 장치에 두면 서로를 방해하므로, 분리하면 각 단계에 맞는 자원 구성을 따로 줄 수 있다. DistServe와 Splitwise가 이 구조를 각각 제시했고[36,37], Mooncake는 KV 캐시를 중심에 둔 분리 아키텍처로 확장했다[38]. 이 구조에서는 메모리 바운드인 디코딩에 더 큰 텐서 병렬도를, 연산 바운드인 프리필에 더 작은 텐서 병렬도를 적용하는식의 구성이 가능하며, 프리필 워커 수와 디코딩 워커 수를 실행 중에 재구성하는 설계도 제시되었다[39]. 쿠버네티스 계층에서도 이를 수용하는 흐름이 형성되었다. llm-d는 추론 스케줄러가 모델 라우팅과 흐름 제어, 분리 오케스트레이션을 담당하고, 서빙 엔진이 점대점 분리 서빙을 기본 프로토콜로 지원하며, 원격 프리픽스 캐시가 복제본 확장과 캐시 적중률을 분리하는 3계층 구조를 제안한다[40].
이 분리 구조는 이종 장치 활용의 자연스러운 진입점이 된다. 단계별로 요구하는 자원 특성이 다르므로, 장치의 강점과 단계를 대응시킬 여지가 생기기 때문이다. 이 방향은 국내에서 이미 상용 수준으로 구현되어 있다. 모레의 추론 프레임워크는 서로 다른 벤더의 가속기에 프리필과 디코딩을 나누어 배치하는 크로스 벤더 분리 구조를 구현해, 단일 벤더 클러스터 대비 최대 43% 낮은 지연과 67% 높은 처리량을 제시한다[15]. 또한, 이 프레임워크는 엔비디아‧AMD‧NPU를 단일 클러스터에서 통합 운용하는 분리 추론 솔루션으로 소개되며, 특정 NPU를 프리필 전용 가속기로 활용해 고대역폭 메모리 사용을 줄이고 전체 인프라 비용을 낮추는 구성이 제시되었다[15]. 국내 NPU 벤더의 서빙 스택에서도 인코더를 분리하는 기능과 자동 프리픽스 캐싱이 제공되고 있어[6], 분리와 캐시 재사용이 장치 수준에서도 전제되어 가는 모습이다.
이종 환경 자체를 목적함수에 넣는 연구도 축적되어 왔다. Melange는 성능과 가격이 다른 GPU가 섞인 조건에서 비용 효율적 배치를 다루었고[41], Helix는 이종 가속기와 네트워크를 최대 유량 문제로 정식화해 모델 계층 배치와 요청 라우팅을 함께 최적화했다[42]. SLO를 제약으로 두고 대기열을 관리하는 접근과[43] DynamoLLM처럼 성능과 에너지를 함께 목적으로 삼는 방향도 정리되었다[44].
다만 자원관리 계층의 관점에서는 여전히 문제가 남는다. 분리 구조는 자원의 종류가 아니라 역할을 구분하는 것이어서, 기존 자원 모델에는 이를 담을 자리가 마땅하지 않다. 프리필 풀과 디코딩 풀은 같은 종류의 장치를 다른 역할로 묶은 집합인데, 스케줄러에게는 둘을 구별해 표현할 속성이 없다. 최근 오케스트레이션 계층이 파드보다 큰 구성 단위와 시작 순서 제어를 도입하는 것은[18] 이 간격을 메우려는 시도로 볼 수 있다.
5. 관측성 및 전력 인지 자율 최적화
정책 기반 자원관리는 관측을 전제로 성립한다. 그러나 이종 환경에서 관측 자체가 선결 과제가 되는 상황이 발생한다. 다중 벤더 가속기를 함께 다루는 오픈소스 모니터링 도구는 리벨리온 NPU를 rbln-stat, 퓨리오사 NPU를 furiosa-smi, 텐스토렌트 NPU를 luwen 라이브러리 경로로 각각 수집하며, 벤더별 진단 항목을 별도 범주로 관리한다[12]. 국내 NPU 벤더도 자체 관리 데몬과 장치 모니터링 도구, 쿠버네티스용 메트릭 익스포터를 제공하고 있어[6], 노출 경로는 확보되는 추세다.
문제는 경로가 아니라 의미의 정합이다. 앞서 살펴본 라벨 스키마 변경 사례처럼, 이종 지표를 하나의 스키마에 담으려는 시도는 기존 규약과 충돌하는 지점을 만든다. 지표의 종류도 장치마다 다르다. 어떤 장치는 코어 단위 사용률과 전력 거버너 모드를 노출하고, 어떤 장치는 성능 상태와 드라이버 버전을 노출한다. 이 상태에서는 ‘클러스터 전체의 가속기 활용률’과 같은 단일 값을 정의하는 일조차 간단하지 않다.
전력은 별도의 제약 조건으로 다루어지기 시작했다. 추론 전용 데이터센터에서 한정된 전력으로 얼마나 많은 토큰을 생성하는지가 핵심 지표로 제시되고[45], 업체 발표 기준으로 카드당 소모 전력과 초당 토큰 생성량을 함께 비교하는 방식이 통용되고 있다. 관측 계층에도 이 관심이 반영된다. 앞서 언급한 모니터링 도구는 누적 에너지와 단가 기반 비용을 함께 표시하고, 에너지 카운터를 선행 기록 로그로 영속화해 재시작 이후에도 누적값이 유지되도록 설계되었다[12]. 성능과 에너지 효율을 동시 목적으로 삼아 추론 클러스터를 설계하는 연구도 제시된 바 있다[44].
표 2는 이 장에서 살펴본 기술들을 자원관리 계층과 관리 대상 자원의 두 축으로 배치한 것이다. 연산 자원 열은 세 계층이 모두 채워져 있으나 오른쪽으로 갈수록 비며, 특히 할당‧스케줄링 행의 공백이 뚜렷하다. 장치는 확보되었고 실행 계층도 정비되었으나 그 둘을 잇는 자원 할당 계층이 연산 자원에 머물러 있는 구조로 요약할 수 있다.
IV. 국내외 추진 현황 및 표준화 동향
1. 국내 추진 현황
국내에서는 국산 AI 반도체를 데이터센터에 적용하는 사업이 단계적으로 추진되어 왔다. 2023년 착수된 K-클라우드 프로젝트는 2030년까지 국산 AI 반도체를 NPU, 저전력 PIM, 극저전력 PIM의 3단계에 걸쳐 고도화하고 단계별로 데이터센터에 적용해 클라우드 기반 AI 서비스를 제공하는 실증까지 함께 추진하는 구조로 설계되었다[3].
이후 후속 기술개발 사업이 이어졌다. 여기에는 하드웨어 분야 기업과 소프트웨어 분야 기업, 주요 대학 및 연구 기관이 참여하고, 국산 AI 반도체 기반 AI 컴퓨팅 인프라의 성능효율을 2030년 글로벌 상위 수준으로 끌어올려 하이퍼스케일급 데이터센터를 구축‧운영할 수 있는 기술 확보를 목표로 제시했다[3].
이러한 사업 구조에서 주목할 점은 하드웨어 개발과 자원관리 소프트웨어 개발이 같은 사업 안에 묶여 있다는 것이다. 국산 장치의 성능만으로는 데이터센터 도입이 성립하지 않는다는 인식이 사업 설계에 반영된 결과로 볼 수 있다.
수요 측 기반도 형성되고 있다. 대규모 국가 AI 컴퓨팅 인프라 구축이 추진되면서 국산 NPU를 일정 비중 이상 도입하겠다는 방향이 제시되어 왔고, 공공 부문을 중심으로 국산 NPU 확산이 추진되는 가운데 새로 지어지는 데이터센터의 상당 부분이 추론용으로 구축되는 상황에서 한정된 전력으로 얼마나 많은 토큰을 생성하는지가 핵심 과제로 제시되고 있다[45].
개방형 생태계 협력도 진행되었다. 2026년 7월 과학기술정보통신부는 AMD와 양해각서를 체결하고, AMD의 CPU‧GPU와 국산 NPU를 연계한 이 기종 AI 컴퓨팅 인프라 구축을 함께 추진하기로 했다[46]. 국산 장치를 단독 대안으로 두기보다 기존 생태계와 혼성 구성하는 방향이 정책 차원에서도 전제되고 있음을 보여준다.
2. 국외 동향
국외에서는 클라우드 사업자가 자체 가속기를 확보하고 이를 자사 관리 계층에 수직 통합하는 흐름이 이어져 왔다. AWS는 추론용 Inferentia와 학습용 Trainium을 SageMaker 계열 서비스에 통합했고, Google은 Cloud TPU를 Vertex AI와 함께 제공한다. Microsoft는 Azure Machine Learning에서 GPU와 자체 가속기를 함께 관리하는 구성을 취한다. 이 경우 자원관리 계층이 사업자 내부에 갇히므로, 이종 장치의 통합 관리가 공개된 문제로 다루어질 필요가 상대적으로 적다. 특정 벤더에 종속되지 않는 관리 계층의 필요는 오히려 사업자 외부에서 제기되며, Red Hat이 llm-d 커뮤니티를 출범시키고[40] NVIDIA가 Dynamo‧Grove‧KAI Scheduler를 공개한 것[18,39], 그리고 DRA 드라이버를 CNCF에 이전한 것[17]이 그 흐름에 해당한다.
이러한 개방 수요에 국내 장치가 대응하는 사례도 나타난다. 퓨리오사AI의 RNGD는 Equinix의 리스본 데이터센터에 배치되어, GPU 클러스터의 추론 대안을 찾는 유럽 기업과 소버린 AI 프로젝트를 겨냥하는 첫 유럽 진출 사례가 되었다[47]. 리벨리온은 ARM과의 협력으로 자사 카드와 ARM CPU를 결합한 서버 플랫폼을 구성하고 SK텔레콤이 자사 AI 데이터센터에서 소버린 AI 모델과 통신 규모 워크로드로 검증하는 구도를 발표했다[48]. 국내 NPU 벤더의 SDK가 Red Hat AI Enterprise를 파트너 솔루션으로 문서화하고 있는 점도[6] 같은 맥락에서 볼 수 있다. 이러한 수요는 자원관리 계층의 개방성을 요구한다는 점에서, 앞서 살펴본 벤더별 병렬 스택 문제와 직접 연결된다.
3. 표준화 동향
표준화 진행 정도는 계층에 따라 크게 다르다. 장치와 인터커넥트 계층은 비교적 정비되어 있다. CXL은 컨소시엄을 중심으로 세대를 거듭해 왔고[32], 국내 기업의 제품도 CXL 3.2 기반 대용량 모듈까지 확장되었다[49]. PIM 역시 LPDDR6-PIM의 표준 논의가 상당 부분 진행되었다[23]. 칩렛 인터커넥트에서도 UCIe 기반 다중 칩렛 설계가 국내 장치를 통해 구현된 사례가 등장하였다[7].
오케스트레이션 계층에서는 특정 벤더 구현이 중립 재단으로 이전되는 방식의 진전이 있었다. DRA 드라이버의 CNCF 기부가 그 예이며[17], 이는 장치 스케줄링의 사실상 표준이 벤더 고유 플러그인에서 공통 API로 이동하는 계기가 되었다. 앞서 확인한 것처럼 국내 NPU 벤더도 여기에 대응하고 있다[6].
V. 시사점 및 향후 연구 방향
1. 이종 자원 표현 모델의 표준 공백
앞선 검토에서 반복적으로 확인된 것은, 개별 장치의 관리 기능이 아니라 장치들을 가로지르는 공통 표현이 부재하다는 점이다. 표 2의 분포가 이를 요약한다. 왼쪽 열의 연산 장치는 세 계층 모두 채워져 있으나, 오른쪽으로 갈수록 특히 할당‧스케줄링 행이 빈다. 장치는 나왔고 실행 계층도 붙었으나, 둘을 잇는 자원 할당 계층만 연산 자원에 머물러 있는 구조다.
DRA는 장치를 속성(Attribute)으로 기술하는 틀을 제공했다는 점에서 발전이 있었지만[16], 그 틀 안에 무엇을 어떤 이름으로 담을지에 대한 합의는 별개의 문제로 남아 있다. 앞서 살펴본 모니터링 도구의 라벨 스키마 변경은 이 사정이 구현 수준에서 드러난 사례로 볼 수 있다[12]. 비NVIDIA 가속기를 수용하려면 기존 규약을 깨야 했고, 그 결정은 개별 프로젝트가 감당했다.
따라서 필요한 것은 새로운 프레임워크보다 공통 속성 집합에 대한 최소 합의에 가깝다. 세대‧메모리 용량‧대역폭‧격리 가능 단위처럼 장치 유형을 넘어 공통으로 의미가 성립하는 항목을 우선 정하고, 벤더 고유 속성은 그 위에 확장으로 두는 방식이 현실적일 것이다. 나아가 연산 장치에 한정된 자원 개념을 넓혀, CXL 확장 메모리의 용량과 데이터 경로 오프로딩의 가용 여부를 자원 요청에 표현할 수 있게 하는 것도 과제로 남는다. DRA 드라이버가 중립 재단으로 이전된 것은[17] 이러한 합의를 시도할 자리가 마련되었다는 의미로 볼 수 있다.
2. 동적 자원 할당의 실용성 격차와 완화 기법
기능적 지원과 실용적 활용은 구분해서 볼 필요가 있다. DRA는 자원 청구의 표현력을 개선했으나, 그것이 곧 실서비스에서 장치를 유연하게 떼고 붙일 수 있음을 뜻하지는 않는다. 제어 평면이 줄여준 비용과 실제로 재배치를 가로막는 비용이 서로 다른 시간 척도에 있기 때문이다. 장치를 청구하고 해제하는 일은 밀리초 단위지만, 그 장치가 서비스 가능한 상태가 되기까지는 대규모 가중치를 장치 메모리에 올리고 실행 상태를 준비하는 과정이 필요하다.
준비 비용은 세 층으로 쌓인다. 첫째는 가중치 적재로, 스토리지‧네트워크 대역폭에 지배된다. 둘째는 실행 상태 준비로, 컴파일과 그래프 캡처, KV 캐시 초기화가 포함된다. 한 서버리스 사업자의 관찰에서 컨테이너 이미지 확보는 이미 병목이 아니며 실제 비용은 그 이후의 초기화 경로에 놓여 있다고 지적된 바 있다[22]. 셋째는 분산 상태로, 병렬 그룹 재구성과 프리픽스 캐시의 예열 상태가 여기 해당하며 재배치 시 대부분 소실된다. 이 관점에서 가속기는 무상태 장치라기보다 준비 비용이 지배적인 상태 저장 장치에 가깝고, 청구‧해제 모델은 전자를 전제로 설계되어 있다.
이 문제는 이종 환경에서 한층 복잡해진다. 국내 NPU는 대체로 사전 컴파일 모델을 취하고 입력 형상별 변형을 준비하므로[6], 준비 단계의 길이만이 아니라 성격 자체가 GPU와 다르다. 즉 장치마다 준비 지연이 다른데, 현재의 스케줄링 정책은 이를 배치 결정의 비용으로 다루지 않는다.
완화 방향은 세 갈래로 정리할 수 있다.
첫째, 재구축 비용을 줄이는 방향이다. ServerlessLLM은 적재에 최적화된 체크포인트 형식과 다계층 저장 시스템으로 기존 방식 대비 수 배의 적재 속도를 달성하고, 진행 중인 추론을 이전할 때 거대한 KV 캐시 대신 토큰만 전송한 뒤 목적지에서 재계산하며, 계층별 적재 시간과 이전 시간의 비용 모델로 시작 지연이 가장 작은 서버를 선택한다[50]. 프로세스 수준 체크포인트‧복원을 활용하는 접근도 등장했다. CRIU에 GPU 상태 스냅샷 기능이 통합되고[51], 이를 쿠버네티스 환경의 빠른 시작에 적용하는 시도가 나오고 있다. 다만 이 방향에는 손익분기가 존재한다. 예열된 컨테이너의 체크포인트 자체가 크기 때문에, 복원은 그만큼의 데이터를 콜드스타트보다 빠르게 옮길 수 있을 때만 이득이 되며 스토리지‧네트워크 경로가 설계의 핵심이 된다[22]. 모델 규모가 커지면 이 조건이 성립하기 어려워질 수 있다.
둘째, 상태를 장치 밖으로 옮기는 방향이다. KV 캐시를 외부 계층에 두면 워커가 보유하는 상태가 모델 가중치로 국한되어, 요청 단위 상태를 잃지 않고도 워커를 교체할 수 있게 된다. LMCache와[52] Mooncake의 캐시 중심 구조[38], 그리고 전송 계층의 정비가 이 방향에 해당하며, 프리필과 디코딩의 분리 역시 재배치 대신 역할 특화로 문제를 우회하는 접근으로 볼 수 있다. 국내에서는 메모리 기업이 관련 오픈소스에 관여하는 움직임이 관찰되어, 메모리 계층과 캐시 계층을 함께 다루려는 관심이 확인된다.
셋째, 재배치 빈도 자체를 줄이는 방향이다. 배치 결정에 지역성을 반영하거나[50], 사용자 대면 경로에 최소 복제본을 상시 예열해 두는 방식이다. 실무 권고 역시 프로덕션 엔드포인트에는 최소 복제본을 유지해 유휴 비용과 콜드스타트 지연을 맞바꾸고 영점 축소는 개발‧스테이징에 한정하는 쪽이다[22]. 이는 현장이 동적성을 일정 부분 포기하고 정적 예약으로 돌아가 있음을 보여주는 대목이기도 하다.
이상을 종합하면, 자원관리 계층에 추가로 필요한 것은 준비도를 표현하는 속성으로 정리된다. 현재의 속성 모델은 장치가 무엇을 제공할 수 있는지는 기술하지만, 그 장치를 얼마나 빨리 쓸 수 있는지는 기술하지 않는다. 특정 모델의 가중치가 이미 적재되어 있는지, 컴파일 산출물이 캐시되어 있는지, 예상 준비 지연이 어느 정도인지를 속성으로 노출할 수 있다면, 지역성 인지 배치와 이종 인지 자동 확장을 같은 틀에서 다룰 여지가 생긴다.
3. 이종 환경 벤치마크와 재현성
효과를 비교 가능한 형태로 제시하기 어렵다는 점도 과제로 남는다. 추론 벤치마크는 지연 분위와 시나리오를 규정하는 방향으로 정비되어 왔으나[14], 이종 장치를 혼성 구성한 환경을 대상으로 하는 규격은 마련되어 있지 않다. Ⅱ장 4절에서 살펴본 것처럼 MFU는 이론 최대 성능을 분모로 삼으므로 장치마다 기준이 달라지고, 전력 효율은 정밀도 형식에 따라 크게 변하며, 관리 오버헤드는 관측 해상도와의 교환에서 결정된다. 여기에 준비 지연이 지표 체계에 포함되어 있지 않다는 문제가 겹친다.
따라서 혼성 구성 자체를 기술하는 방법, 준비 지연을 포함하는 지표, 그리고 공개 요청 트레이스에 기반한 재현 절차가[1] 함께 정리될 필요가 있다. 이는 개별 연구팀이 감당하기 어려운 성격의 과제로, 공동 구축이 요구되는 영역으로 보인다.
4. 국산 장치 생태계 관점의 제언
지금까지의 검토는 국내 기술이 뒤처져 있다는 진단으로 이어지지 않는다. 연산 장치 영역에서는 장치 분할과 QoS가 하드웨어 차원에서 고려되고[5,7], SDK가 컴파일러부터 쿠버네티스 연동까지를 포괄하며[6], 크로스 벤더 분리 추론이 상용 수준으로 구현되어 있다[15]. 메모리 영역에서도 커널 계층 기술이 상류에 반영되었다[8]. 개별 성숙은 상당 부분 이루어졌고, 다음 단계는 상호운용성에 놓여 있다고 보는 편이 적절해 보인다.
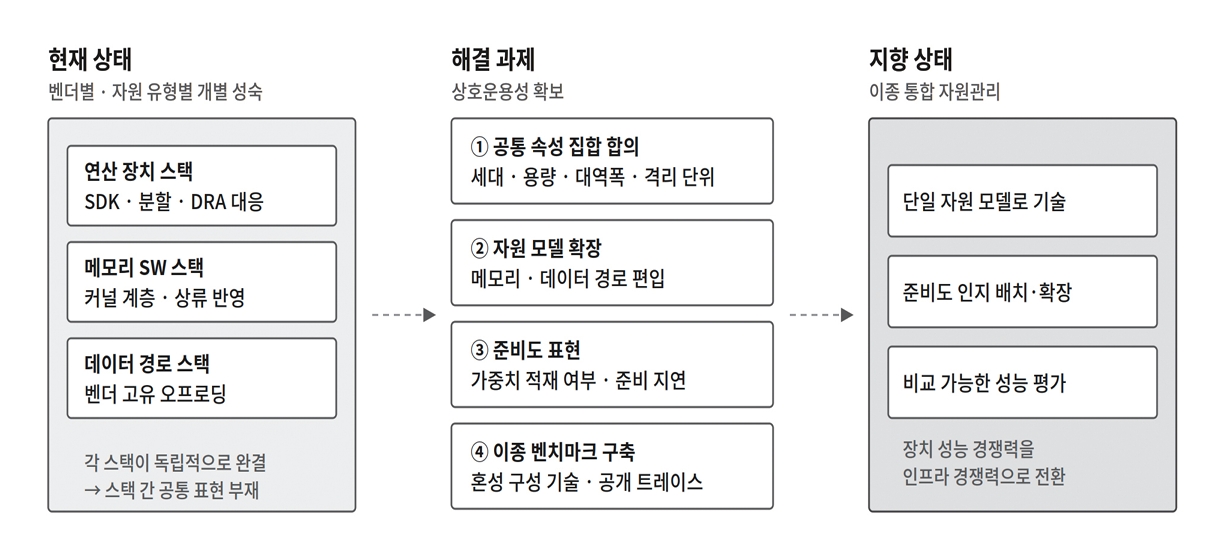
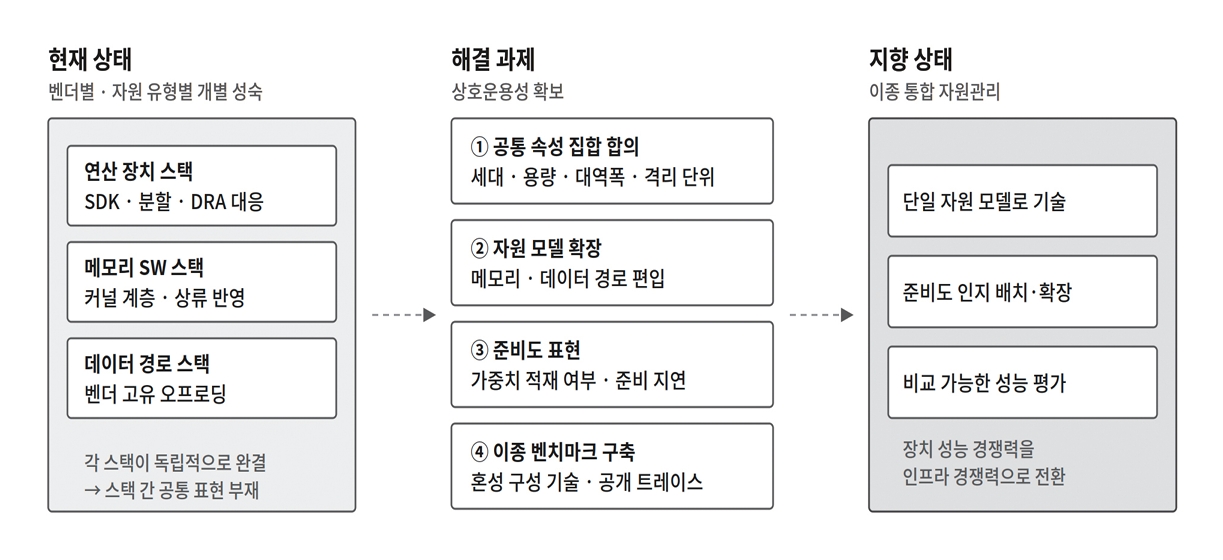
이 관점에서 세 가지를 제언한다. 첫째, 국내 장치 벤더 사이에서 공통 속성 집합에 대한 합의를 시도하고, 이를 표준 논의에 제안하는 것이다. 커널 계층 기술이 메인라인에 반영된 선례가 있어 시도해 볼 여지가 있다. 둘째, 메모리‧데이터 경로 장치를 자원 모델에 편입하는 연구가 필요하다. 현재 이들의 성능 이득은 실증되어 있으나 자원 할당의 대상이 아니어서, 통합 관리의 범위 밖에 놓여 있다. 셋째, 이종 혼성 환경을 대상으로 하는 벤치마크와 공개 트레이스를 국내 참여 기관이 공동으로 구축하는 것이다. 정책 차원에서 국산 장치와 기존 생태계의 혼성 구성이 전제되고 있는 만큼[46], 그 구성을 평가할 공통 기준이 함께 마련되는 것이 바람직해 보인다. 그림 2는 이상의 논의를 현재 상태와 지향 상태의 대비로 정리한 것이다.
VI. 결론
본고는 이종 AI 반도체를 활용하는 인프라에서 통합 자원관리 기술의 동향을 자원관리 계층의 관점에서 정리하였다. 검토를 통해 확인된 바는 다음과 같다.
첫째, 이종 환경의 어려움은 장치 간 성능 차이보다 자원 개념 자체의 불일치에서 비롯되는 측면이 크다. 연산 장치는 개수를 셀 수 있는 대상으로 표현되지만, 메모리 부속 연산과 확장 메모리, 데이터 경로 장치는 기존 자원 모델 안에 담기지 않는다.
둘째, 국내 장치의 관리 기능은 개별적으로는 상당 수준에 이르렀다. 장치 분할과 QoS, 컴파일러부터 오케스트레이션까지의 스택, 크로스 벤더 분리 추론이 확인된다. 공백은 벤더 내부가 아니라 벤더 사이에, 그리고 연산 자원과 그 밖의 자원 사이에 놓여 있다.
셋째, 동적 자원 할당의 표현력이 개선된 것과 실 서비스에서의 유연한 자원 운용이 가능해진 것은 구분해야 한다. 준비 비용이 지배적인 장치의 특성을 자원관리 계층이 아직 표현하지 못하고 있으며, 이 간격을 메우는 것이 향후 과제로 남는다. 또한. 개방형 생태계와의 혼성 구성이 정책 차원에서도 전제되고 있어, 상호운용성 확보는 기술 과제이면서 정책 목표와도 맞물리는 사안으로 볼 수 있다.
이종 AI 반도체의 활용은 장치 성능의 문제에서 자원관리 소프트웨어의 문제로 무게가 옮겨 가고 있다. 국내에서 장치와 관리 소프트웨어가 함께 개발되어 온 조건은 이 국면에서 유리하게 작용할 수 있으며, 상호운용성을 확보하는 작업이 그 조건을 실질적 경쟁력으로 전환하는 관건이 될 것으로 보인다.
참고문헌
그림 1
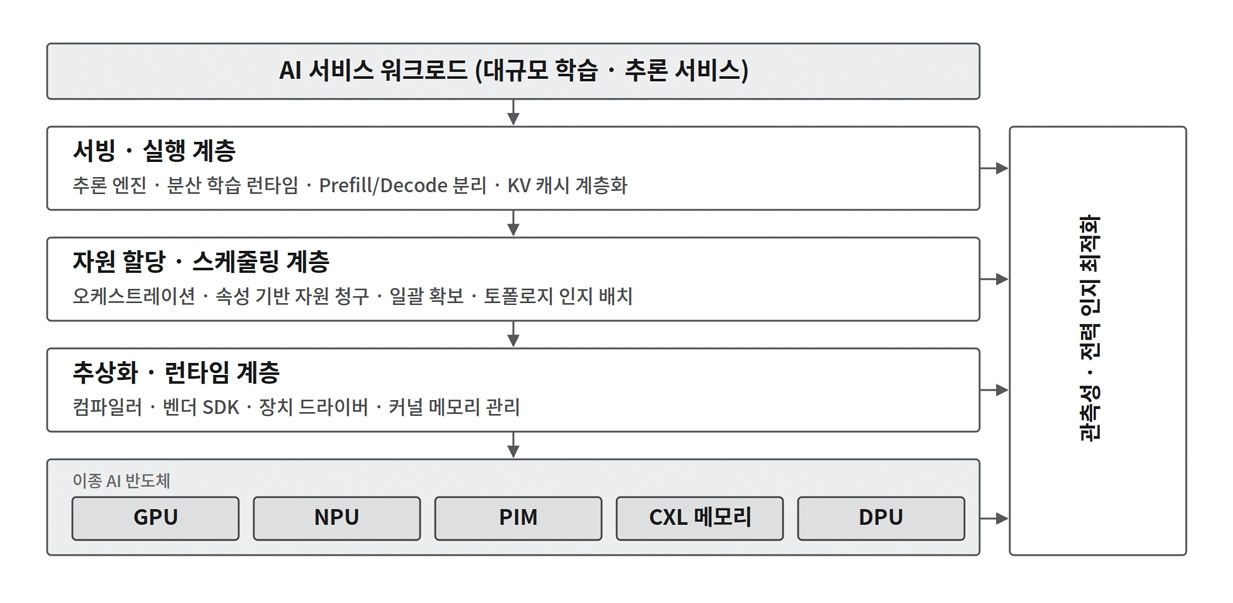
그림 2