조민형 (Cho M.H.)
김이경 (Kim Y.G.)
박경환 (Park K.H.)
I. 서론
최근 생성형 인공지능(AI: Artificial Intelligence)의 급격한 발전과 함께 거대언어모델(LLM: Large Language Model), 멀티모달 AI, 자율주행, 로보틱스 등 다양한 AI 응용 서비스가 빠르게 확산되고 있다. 이러한 AI 서비스는 수백억 개 이상의 파라미터를 실시간으로 처리해야 하므로 막대한 연산 성능과 데이터 처리 능력을 요구하며[1], 이를 지원하기 위한 GPU(Graphics Processing Unit), NPU(Neural Processing Unit), AI 가속기와 같은 AI 반도체의 성능 또한 지속적으로 향상되고 있다.
그러나 메모리의 성능증가 속도가 AI 반도체의 연산 성능을 따라가지 못함으로써, 시스템 전체의 처리 성능은 메모리에 의해 제한되는 경우가 점차 증가하고 있다. AI 연산에서는 대규모 모델 파라미터와 활성화 데이터(Activation), 중간 계산 결과 및 KV 캐시(Key-Value Cache) 등을 반복적으로 읽고 쓰는 과정이 수행되므로, 연산 자체보다 데이터 이동(Data Movement)이 전체 성능과 전력 소모의 상당 부분을 차지한다. 프로세서의 연산 성능 향상 속도에 비해 메모리 성능 향상이 상대적으로 더디게 진행되면서, AI 시스템에서는 이른바 ‘Memory Wall’ 문제가 다시 중요한 기술적 과제로 떠오른다[2,3].
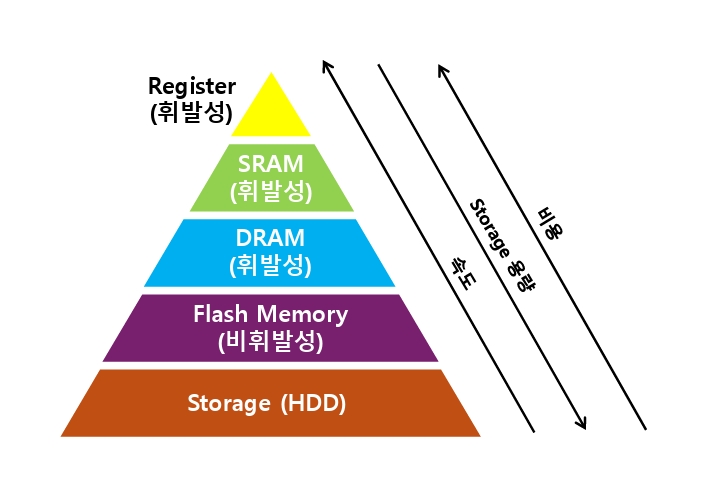
AI 반도체에서 메모리는 단순한 데이터 저장 장치를 넘어 연산 성능과 에너지 효율을 좌우하는 핵심 구성 요소로 자리매김하고 있다. 일반적으로 AI 모델의 가중치(Weight), 활성화 데이터, Feature Map, KV 캐시 및 각종 버퍼(Buffer)는 메모리 계층 구조를 통해 관리되며, 그림 1과 같이 접근 빈도와 요구 성능에 따라 서로 다른 특성을 갖는 메모리가 계층적으로 배치된다. 연산기에 가장 가까운 위치에는 AI 반도체에 함께 내장될 수 있는 Register와 SRAM(Static Random Access Memory)이 배치되어 초저지연 데이터 접근을 담당하며, 보다 큰 용량과 높은 대역폭이 요구되는 영역에는 DRAM(Dynamic Random Access Memory) 계열의 HBM, GDDR, LPDDR 및 DDR 메모리와 시스템 수준의 메모리 확장을 위한 CXL 기반 메모리 등이 함께 사용되어 AI 시스템의 성능과 효율을 최적화하고 있다.
메모리에 따른 응용분야를 살펴보면, AI 반도체 시스템에서는 초고대역폭을 제공하는 HBM이 AI 학습용 가속기의 핵심 메모리로 사용되고 있으며, 저전력 특성을 갖는 LPDDR은 온디바이스 AI를 비롯하여 AI 서버용 메모리로도 적용 범위를 확대하고 있다. 또한, 높은 데이터 전송속도와 경제성을 제공하는 GDDR은 AI GPU 및 추론 가속기에 널리 활용되고 있으며, CXL은 메모리 풀링(Memory Pooling)을 통해 대규모 AI 시스템의 확장성을 향상시키는 핵심 기술로 주목받고 있다. 더불어 메모리 내부에서 직접 연산을 수행하는 PIM(Processing-In-Memory) 기술은 데이터 이동으로 인한 병목을 근본적으로 해결할 수 있는 차세대 AI 컴퓨팅 기술로 활발히 연구되고 있다.
이에 따라 AI 반도체용 메모리 기술은 단순히 저장 용량과 전송 속도를 높이는 데 그치지 않고 전력 효율, 시스템 확장성, 첨단 패키징 및 메모리-연산 융합 기술을 함께 고려하는 방향으로 발전하고 있다.
본고에서는 AI 반도체에서 사용되는 HBM, LPDDR, GDDR, CXL 및 PIM 기술의 최신 연구 및 산업 동향을 살펴본 후, 차세대 메모리 기술의 발전 방향을 고찰함으로써 AI 시대의 메모리 기술이 나아갈 방향을 전망하고자 한다.
II. 주요 메모리 기술 현황
1. High Bandwidth Memory(HBM)
그림 1 AI 반도체 메모리 계층 구조 HBM은 여러 개의 DRAM 다이(Die)를 수직으로 적층하고 TSV(Through-Silicon Via)를 이용해 다이와 다이 사이를 연결하는 고대역폭 메모리이다. GPU 또는 AI 가속기 등의 프로세서와 HBM 스택은 실리콘 인터포저나 고밀도 재배선(RDL: Redistribution Layer) 구조를 통해 하나의 패키지 안에서 연결된다. 기존 GDDR이 핀당 전송속도를 높여 전체 대역폭을 확보하는 방식이라면, HBM은 수천 개의 넓은 인터페이스를 이용해 상대적으로 낮은 동작 주파수에서도 높은 총 대역폭을 제공한다.
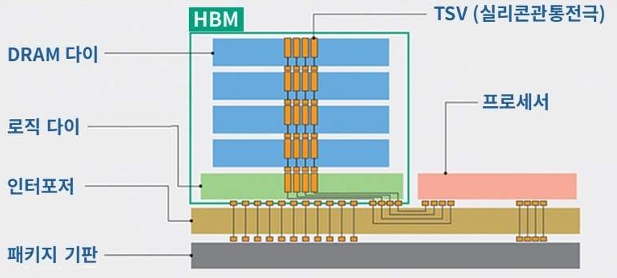
HBM 메모리의 기본 구조는 그림 2와 같다. HBM은 상부의 여러 DRAM 다이와 하부의 로직 또는 베이스 다이, 다이를 수직으로 연결하는 TSV, 프로세서와 HBM을 연결하는 인터포저 및 패키지 기판으로 구성된다. TSV는 다이 사이의 데이터와 제어 신호를 짧은 경로로 전달하며, 인터포저는 프로세서와 HBM 사이에 수천 개의 미세 배선을 구현한다. 이러한 구조는 높은 대역폭과 전력 효율을 가능하게 하지만, 적층 수율, 신호 무결성, 전력 공급 및 열 방출을 동시에 해결해야 한다
HBM 메모리의 세대별 주요 특징은 표 1에서 살펴볼 수 있고, JEDEC에서는 최신 규격인 6세대 HBM4(JESD270-4) 표준을 2025년에 발표하였다. HBM의 세대별 발전 방향은 단순히 핀(Pin)당 속도 향상에서 인터페이스 폭, 채널 병렬성, 적층 용량 및 로직 기능을 함께 확대하는 방향으로 변화해 왔다. HBM2와 HBM2E는 용량과 적층 수를 늘리고 전송속도를 높였으며, HBM3는 독립 채널 수와 신뢰성 기능을 강화하였다. 그리고 가장 최신 규격인 HBM4는 I/O 폭을 2,048비트(Bit)로 이전 세대 대비 2배로 확대하여 대역폭을 높였다[4]. 그리고 베이스 다이(Base Die)를 메모리 공정 대신 로직 공정으로 제작한 다이를 사용함으로써 AI 가속기와의 인터페이스 성능과 전력 효율을 향상시킴과 동시에 AI 가속기의 요구사항에 최적화된 맞춤형(Custom) HBM 개발도 가능하게 되었다.
표 1 HBM 메모리 표준규격 및 주요 특징
한편, HBM4 이후의 차세대 규격인 HBM5는 2027년 말 제품 출시를 목표로 2025년부터 표준화 논의가 시작되었으며, 2026년 하반기에는 예비 규격 발표가 예정되어 있다. HBM5는 HBM4와 동일한 2,048비트 I/O 폭을 유지하면서도, 12.8~16.0Gbps 이상의 핀당 전송속도로 높여 HBM4 대비 약 2배 대역폭을 달성하는 것을 목표로 하고 있다.
현재 국내 메모리 업체인 SK하이닉스와 삼성전자는 NVIDIA사의 최신 AI 플랫폼인 Vera Rubin 플랫폼에 HBM4 메모리를 공급하고 있어 HBM 시장에서 독보적으로 시장을 점유하고 있으며, 차세대 규격인 HBM4E 제품의 샘플을 선제적으로 공개하고 있어 기술 주도권도 놓치지 않고 있다.
향후 HBM 경쟁력은 DRAM 셀의 미세화를 비롯하여 TSV, 마이크로범프 및 하이브리드 본딩, 인터포저, 패키지 기판, 테스트 및 열관리 기술을 함께 최적화해야 하며, 고객의 가속기 구조와 워크로드에 맞춘 맞춤형 HBM도 중요한 발전 방향이 될 것으로 예상된다.
2. Low Power Double Data Rate (LPDDR)
LPDDR 메모리는 스마트폰과 태블릿 등 배터리 기반의 기기를 위해 개발된 저전력 DRAM 규격이다. 일반 DDR 메모리에 비해 낮은 동작 전압과 다양한 절전모드를 지원함으로써 배터리 기반으로 동작하는 모바일 환경에서 저전력 및 고성능 메모리의 공급을 목표로 개발되었다. 최근 AI 서비스가 클라우드 중심에서 스마트폰, 자율주행 차량, 로봇과 같은 온디바이스 AI로 확대되면서 LPDDR은 기존의 모바일용 메모리를 넘어 AI 반도체의 핵심 메모리 중 하나로 자리 잡고 있다. 그리고 최근에는 서버에서도 전력소모 및 폼팩터의 소형화 이슈로 인하여 CPU의 메인 메모리로 LPDDR 메모리를 채택하는 경우가 증가하고 있다. NVIDIA에서 가장 최근에 발표한 AI 플랫폼인 Vera Rubin 플랫폼에서 NPU인 Rubin 프로세서의 메모리로는 HBM을 사용하나 CPU인 Vera 프로세서의 메모리로는 LPDDR5X 메모리를 사용한다.
LPDDR 메모리는 표 2와 같이 JEDEC에서 표준화가 계속 진행되고 있으며, 2025년에는 LPDDR6 규격이 발표되었다. LPDDR은 세대를 거듭할수록 동작 전압과 대기전력을 줄이면서 전송속도와 전력 효율을 높이는 방향으로 발전해 왔다. LPDDR4 이후에는 복수의 독립 채널과 세분화된 접근 구조를 통해 효율을 높였으며, LPDDR5에서는 동작 조건에 따라 전압과 주파수를 조절하는 기능과 I/O 인터페이스의 동작 전원전압을 0.5V로 하여 메모리 인터페이스에서의 전력 소모를 낮춰 저전력 특성을 유지하였다. 그리고 가장 최신 규격인 LPDDR6에서는 대역폭 확보를 위해 핀당 데이터 전송 속도를 14.4Gbps로 높임과 동시에 채널당 데이터 I/O 수를 16비트에서 24비트로 확대하는 새로운 채널 구조를 적용하였다[5]. 그리고 저전력 동작을 위해 기존에 적용하던 동작 조건에 따른 전압 및 주파수 조절 기능을 보다 세분화하여 고도화하는 것과 동시에 24비트 채널을 12비트 단위의 서브채널 구조로 설계하여 저부하 동작 조건에서는 하나의 12비트 서브채널만을 사용하여 데이터를 주고받는 Efficiency 모드를 추가로 도입하였다. 그리고 온디바이스 AI로의 활용을 고려하여 데이터의 신뢰성 및 안정성 향상을 위해 다양한 기능(On-Die ECC, PRAC 등)들을 추가하였다.
표 2 LPDDR 메모리 표준규격 및 주요 특징
LPDDR 메모리의 저전력 및 소형 폼팩터 특성을 기반으로 서버에 적용하기 위한 새로운 모듈 규격인 SOCAMM(System on Chip Advanced Memory Module)은 엔비디아를 중심으로 개발되었다. LPDDR5X 메모리를 적용하는 SOCAMM2 규격은 2026년 JEDEC에서 표준화를 발표하였고, 현재 AI 서버에 적용되고 있다. 그리고 LPDDR6 메모리를 기반으로 한 차세대 SOCAMM 모듈도 개발 및 표준화가 진행 중이다.
LPDDR 메모리의 또 다른 응용 중 하나는 PIM에 적용하는 것이다. Memory Wall 문제 완화를 위해 메모리 안에서 직접 연산을 수행하는 PIM 기술은 삼성전자에서 LPDDR5를 기반으로 개발하여 성능 향상을 확인하였고, 이를 바탕으로 다른 메모리 중에서 가장 먼저 LPDDR6-PIM 표준이 JEDEC에서 논의되고 있다. LPDDR6-PIM을 사용하면 AI 연산 수행 시 데이터 이동을 최소화할 수 있어 높은 성능 및 전력효율을 가지는 AI 추론 시스템 구성이 가능하며, 특히 저전력 특성이 요구되는 온디바이스 AI 분야에 적극적인 채택이 기대된다.
3. Graphics Double Data Rate (GDDR)
GDDR은 그래픽 처리장치(GPU)를 위해 개발된 고속 DRAM으로 칩당 32개의 데이터 I/O핀을 갖고, 핀당 데이터 전송 속도를 높이는 방향으로 데이터 대역폭을 확보하도록 기술 개발이 진행되고 있다. HBM에 비해 데이터 I/O 개수는 적지만 PCB 위에 여러 개의 메모리 패키지를 배치하는 비교적 전통적인 구조를 사용할 수 있어 시스템 구현 비용과 복잡도를 낮출 수 있다. 이와 같은 이유로 GDDR은 그래픽 처리뿐만 아니라 중‧고성능 AI 추론 가속기와 저비용의 AI 시스템에서도 적용된다.
GDDR 메모리 역시 JEDEC에서 표준화가 계속 진행되고 있으며, 2024년 GDDR7 규격이 발표되었다. GDDR 메모리의 세대별 주요 특징은 표 3과 같다. GDDR 표준 중에서 GDDR6X는 특정 업체 요구사항에 의해 JEDEC과는 별개의 제품군이 개발되었으나, GDDR6X의 주요 기술은 GDDR7 표준에서 통합되어 표준화되었다.
표 3 GDDR 메모리 표준규격 및 주요 특징
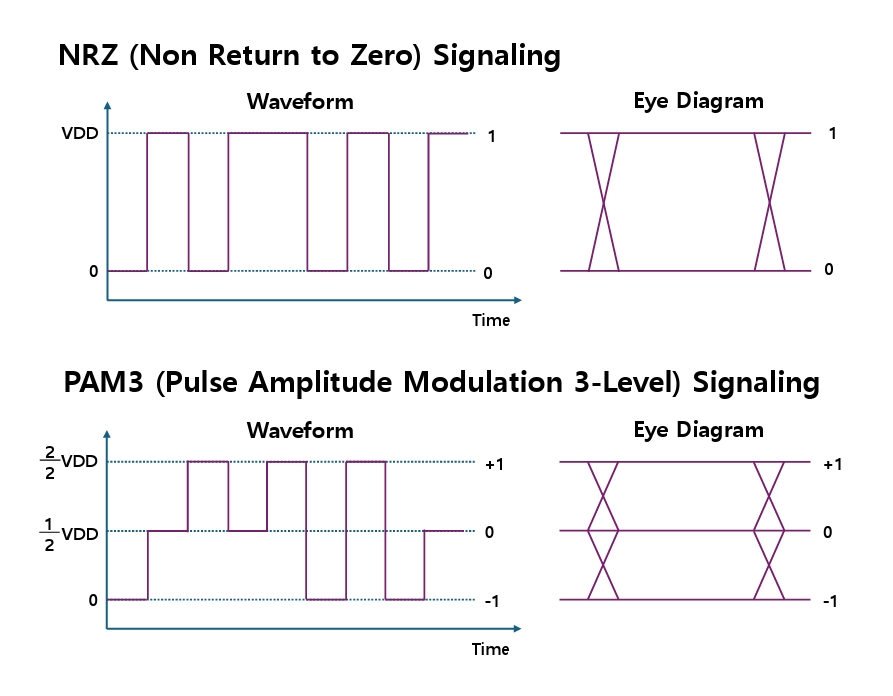
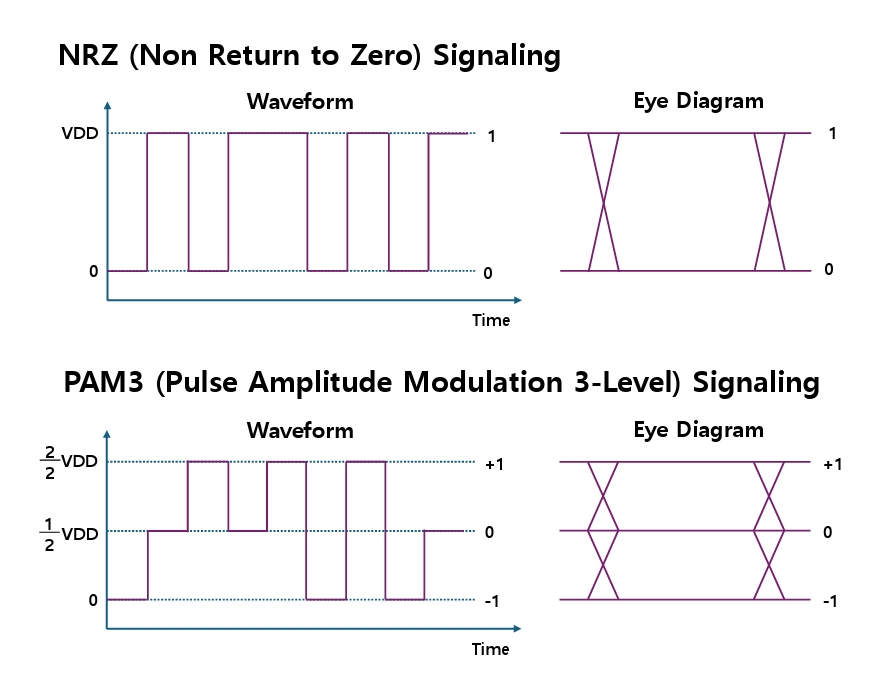
최근의 GDDR 발전 방향을 살펴보면, GDDR5X는 프리패치 구조를 확대해 GDDR5 대비 전송률을 높였고, GDDR6는 채널 구조와 전력 효율을 개선하였다. GDDR6X는 PAM4(Pulse Amplitude Modulation) 신호를 이용해 더 높은 데이터 전송속도를 구현하였고, 최신 규격인 GDDR7은 PAM3 기반 신호 전송방식을 도입하였다. 그림 3과 같이 PAM3은 +1, 0, -1을 전송하는 방식으로 기존 NRZ에서 1과 0을 전송하는 방식보다 동일한 채널에서 더 높은 데이터 전송 속도를 제공할 수 있어 단일 채널 성능 향상에 유리하고, 이를 통하여 GDDR7은 핀당 최대 48Gbps의 데이터 전송 속도와 메모리당 192GB/s의 대역폭을 확보할 수 있다[6]. 다만, 다중 레벨 신호 전송은 신호 무결성과 회로 복잡도가 증가하는 단점이 있으므로 고속 인터페이스 설계 기술이 더욱 중요해지고 있다.
HBM이 최고 수준의 대역폭 성능을 기반으로 고성능 학습 및 추론 시스템에 적용되는 것 대비 GDDR은 비교적 낮은 시스템 비용과 상대적으로 높은 성능을 확보해야 하는 AI 추론 서버, 엣지 AI 시스템 등 비용 민감형 AI 가속기에 활용되어 HBM과 상호 보완적인 역할을 수행할 것으로 전망된다.
4. Compute Express Link(CXL)
CXL은 PCI Express 기반으로 개발된 차세대 고속 인터커넥트 기술로, CPU와 GPU, AI 가속기 및 메모리를 하나의 일관된(Coherent) 시스템으로 연결하여 시스템 성능 향상과 데이터 처리 효율성을 증대시키기 위해 제안되었다. 기존 서버 시스템에서는 CPU가 장착 가능한 메모리 슬롯 수에 물리적인 한계가 존재하므로 AI 모델 규모가 증가할수록 메모리 부족 문제가 발생하였다. CXL은 이러한 한계를 해결하기 위해 메모리를 독립적인 시스템 자원으로 관리하는 새로운 개념을 도입하였다.
표 4와 같이 CXL의 가장 큰 특징은 메모리 풀링(Memory Pooling) 기능이다. 메모리를 특정 프로세서에 종속시키지 않고 여러 CPU와 AI 가속기가 공유할 수 있도록 함으로써 자원 활용 효율을 크게 향상시킬 수 있다. 특히 대규모 언어모델 추론 과정에서 발생하는 KV 캐시 저장 공간 부족 문제를 해결하는 유력한 기술로 평가받고 있으며, AI 데이터센터에서 높은 관심을 받고 있다.
표 4 CXL 버전별 특징
CXL 기술은 CXL 2.0 기반 상용 제품이 등장하면서 글로벌 서버 플랫폼에 본격적으로 적용되기 시작하였으며, CXL 3.0 표준에서는 메모리 공유 및 다중 장치 연결 기능이 더욱 강화되고 있다[7]. 삼성전자와 SK하이닉스는 CMM-D(CXL Memory Module-DRAM)와 같은 대용량 CXL 메모리 모듈을 개발하고 있으며, 국내외 팹리스 기업들도 CXL 컨트롤러 및 IP 시장에 적극 진출하고 있다.
그러나 CXL은 GPU 간 초고속 통신을 위한 NVLink와 비교할 때 지연시간과 최고 대역폭 측면에서 아직 개선이 필요한 부분이 존재한다. 또한, 대규모 시스템 구축 비용과 소프트웨어 생태계 성숙도 역시 해결해야 할 과제로 남아 있다. 그럼에도 불구하고 CXL은 AI 시스템의 메모리 확장성을 획기적으로 향상시킬 수 있는 핵심 기술로 평가받고 있으며, 향후 AI 데이터센터 인프라의 중요한 구성 요소가 될 것으로 예상된다.
5. Processing-in-Memory(PIM)
PIM은 메모리 내부 또는 메모리 근처에 연산 기능을 배치하여 데이터 이동을 최소화하는 새로운 컴퓨팅 구조이다. 기존 폰 노이만(von Neumann) 구조에서는 연산 장치와 메모리가 분리되어 있어 대규모 데이터 이동에 따른 성능 저하와 높은 전력 소비가 발생한다. 특히 AI 연산에서는 동일한 데이터를 반복적으로 읽고 쓰는 과정이 많기 때문에 메모리와 프로세서 사이의 데이터 이동이 시스템 효율을 크게 저하시킨다.
PIM은 이러한 Memory Wall 문제를 해결하기 위한 접근 방식으로, 메모리 내부에서 벡터 연산이나 행렬 곱셈과 같은 AI 핵심 연산을 직접 수행한다. 이를 통해 데이터 이동량을 크게 줄일 수 있으며, 시스템 전체의 에너지 효율과 처리 속도를 동시에 향상시킬 수 있다.
현재 PIM은 구현 방식에 따라 DRAM-PIM, HBM-PIM 및 LPDDR-PIM 등 다양한 형태로 연구되고 있다. HBM-PIM은 초고대역폭 특성을 이용하여 AI 학습 성능을 높이는 방향으로 개발되고 있으며, LPDDR-PIM은 온디바이스 AI 환경에서 저전력 AI 추론을 목표로 연구가 진행되고 있다. 특히, LPDDR-PIM은 JEDEC에서 2025년에 발표된 LPDDR6 표준을 기반으로 LPDDR6-PIM 표준을 제정 중이며, 2026년 하반기 또는 2027년 상반기에 발표될 것으로 예상된다. 삼성전자와 SK하이닉스를 비롯한 국내 메모리 기업들은 PIM 기술을 차세대 AI 메모리의 핵심 경쟁력으로 판단하고 지속적인 연구개발을 수행하고 있다.
그러나 PIM 기술이 상용화되기 위해서는 하드웨어뿐만 아니라 소프트웨어 생태계 구축도 필수적이다. 기존 프로그래밍 모델과 컴파일러는 프로세서 중심으로 설계되어 있기 때문에 메모리 내부 연산을 효율적으로 사용하기 위한 새로운 프로그래밍 환경과 표준화 기술이 요구된다. 또한, 범용성 확보와 연산 정확도 문제도 해결해야 할 과제로 남아 있다.
이와 같이 풀어야 할 기술적인 과제도 많지만, AI 모델 규모가 지속적으로 증가하고 데이터 이동 비용이 시스템 성능의 주요 병목으로 작용하는 상황에서 PIM은 차세대 AI 컴퓨팅 구조를 구현하기 위한 핵심 기술로 평가받고 있다.
III. 차세대 메모리 기술 방향
AI 서비스의 규모가 지속적으로 확대되고 생성형 AI 모델의 파라미터 수가 수천억 개 수준으로 증가함에 따라, 기존 메모리 기술만으로는 성능과 전력 효율을 동시에 만족하기 어려운 상황이 도래하고 있다. 특히 AI 반도체에서는 연산 성능보다 데이터 이동에 따른 지연시간과 에너지 소모가 전체 시스템 효율을 제한하는 주요 요인으로 작용하고 있으며, 이를 해결하기 위한 차세대 메모리 기술 개발이 활발하게 진행되고 있다.
1. High Bandwidth Flash(HBF)
AI 추론에서는 높은 대역폭과 함께 매우 큰 메모리 용량이 요구된다. 모델의 모든 가중치를 HBM에 저장하지 못하면 데이터를 프로세서 메모리나 SSD(Solid State Drive)와 같은 저장장치에서 반복적으로 불러와야 하며, 이 과정에서 인터페이스 병목과 지연시간이 발생한다. HBF는 NAND 플래시를 HBM 메모리와 유사한 고대역폭 적층 구조로 구성하여 기존 SSD보다 높은 병렬성과 대역폭을 제공하는 메모리이다[8].
HBF는 DRAM 기반 HBM보다 높은 용량과 낮은 비트당 비용을 구현할 가능성이 있어 읽기 중심의 모델 가중치 저장 계층으로 주목받고 있다. 연산에 즉시 필요한 활성화 데이터와 빈번하게 갱신되는 KV 캐시는 HBM에 배치하고, 변경 빈도가 낮은 대규모 모델 가중치는 DRAM보다 read latency가 긴 HBF에 배치하는 혼합 구조가 대표적인 적용 방향이다.
다만 현재 HBF는 표준화와 제품 개발이 진행되는 단계이며, 업체가 제시하는 용량과 성능 목표는 실제 제품의 지연시간, 내구성, 전력 및 비용을 통해 검증될 필요가 있다.
2. 차세대 비휘발성 메모리
차세대 메모리 기술의 또 다른 방향은 기존 DRAM의 한계를 극복할 수 있는 새로운 비휘발성 메모리(Non-Volatile Memory)의 도입이다. 현재 연구가 활발하게 이루어지고 있는 대표적인 비휘발성 메모리 기술로는 표 5와 같이 MRAM(Magnetic Random Access Memory), ReRAM(Resistive Random Access Memory) 및 PCM(Phase Change Memory) 등이 있다[9]. 이들 메모리는 전원이 차단되어도 데이터를 유지할 수 있으며, DRAM 대비 우수한 전력 효율과 낮은 대기전력 특성을 제공한다. 또한, 반복적인 Refresh 동작이 필요하지 않아 AI 시스템의 전체 에너지 소비를 감소시킬 수 있는 장점이 있다.
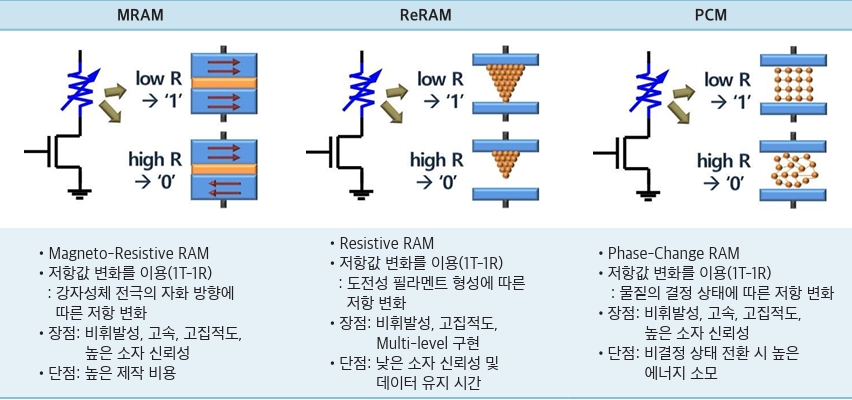
MRAM은 자성체의 스핀(Spin) 특성을 이용하여 정보를 저장하는 방식으로 높은 내구성과 빠른 접근 속도를 제공하며, 차세대 캐시 메모리 및 임베디드 메모리 분야에서 채택될 가능성이 높게 평가되고 있다.
ReRAM은 저항 변화 특성을 이용하여 데이터를 저장하는 구조이며, 아날로그 연산과의 결합이 용이하여 뉴로모픽 컴퓨팅 및 인메모리 컴퓨팅(In-Memory Computing)에 적합한 기술로 주목받고 있다.
PCM은 상변화 물질의 결정 상태를 이용하여 데이터를 저장하며 높은 집적도와 우수한 확장성을 제공하여 대용량 AI 시스템에서의 활용 가능성이 연구되고 있다.
3. 첨단 패키징과 열관리
AI 메모리의 발전은 메모리 셀과 인터페이스 기술만으로 이루어지지 않는다. HBM과 AI 가속기를 하나의 패키지 안에 배치하기 위해서는 실리콘 인터포저, 고밀도 재배선층, 패키지 기판, 미세 접합 및 정밀 테스트 기술이 필요하다. 적층 수와 전송속도가 증가할수록 신호선과 전원선의 밀도가 높아지고, 가속기와 메모리에서 발생하는 열이 좁은 영역에 집중된다.
이에 따라 열압착 본딩, 몰디드 언더필, 하이브리드 구리 본딩 및 웨이퍼 단위 본딩 등 다양한 기술이 발전하고 있다. 칩렛 간 연결을 위한 UCIe 3.0은 서로 다른 공정으로 제조된 로직‧입출력‧가속기 칩렛을 하나의 시스템 인 패키지에서 연결하는 기반을 제공한다.
앞으로 패키징은 완성된 칩을 조립하는 후공정을 넘어 시스템 성능, 전력, 수율 및 비용을 결정하는 핵심 설계 요소가 될 것이다.
4. 이기종 메모리와 소프트웨어 통합
차세대 AI 시스템에서는 SRAM, HBM, GDDR, LPDDR, CXL 메모리, HBF 및 SSD를 조합한 이기종 메모리 구조가 보편화될 가능성이 높다. 각 기술은 지연시간, 대역폭, 용량, 소비전력 및 비용이 다르므로 워크로드의 특성에 따라 역할을 분담해야 한다.
예를 들어 반복적으로 접근하는 활성화 데이터와 KV 캐시는 HBM에 배치하고, CPU가 처리하는 대용량 데이터는 DDR, LPDDR 또는 CXL 메모리에 배치할 수 있다. 변경 빈도가 낮은 모델 가중치와 벡터 데이터베이스는 HBF나 고성능 SSD에 저장할 수 있다.
이러한 구조에서는 데이터 접근 빈도를 분석하여 계층 사이에서 데이터를 이동시키는 운영체제, 런타임 및 컴파일러 기술이 중요하다. 결국 차세대 AI 메모리의 경쟁력은 개별 반도체의 최대 성능뿐만 아니라 컨트롤러, PHY, 인터커넥트, 패키징, 냉각, 컴파일러, 런타임 및 메모리 관리 알고리즘을 포함한 전체 생태계의 완성도에 의해 결정될 것이다.
IV. 결론
생성형 AI와 초거대 언어모델의 발전으로 AI 반도체의 성능 요구사항이 급격히 증가하면서, 메모리 기술은 단순한 데이터 저장 장치를 넘어 시스템 성능을 결정하는 핵심 요소로 인식되고 있다. 특히 대규모 AI 모델에서는 데이터 이동에 따른 지연시간과 전력 소모가 주요 병목으로 작용하기 때문에, 메모리의 대역폭과 전력 효율, 확장성이 AI 시스템의 경쟁력을 좌우하는 중요한 요소가 되고 있다.
본고에서는 AI 반도체에 적용되는 대표적인 메모리 기술인 HBM, LPDDR, GDDR, CXL 및 PIM의 특징과 최신 기술 동향을 살펴보았다. HBM은 초고대역폭을 기반으로 AI 학습용 시스템의 핵심 메모리로 자리 잡고 있으며, LPDDR은 우수한 전력 효율을 바탕으로 온디바이스 AI와 AI 서버 분야로 적용 범위를 확대하고 있다. 또한 GDDR은 성능과 경제성을 동시에 제공하는 메모리로 사용되고 있으며, CXL과 PIM은 메모리 확장성과 데이터 이동 효율을 개선하기 위한 차세대 기술로 주목받고 있다.
향후 AI 모델의 규모와 복잡성은 지속적으로 증가할 것으로 예상되며, 이에 따라 메모리 기술 또한 더욱 높은 대역폭, 낮은 소비전력, 넓은 확장성을 갖는 방향으로 발전할 것이다. 나아가 차세대 비휘발성 메모리와 메모리-연산 융합 기술, 첨단 패키징 기술이 함께 발전하면서 AI 반도체의 성능 향상을 이끄는 핵심 동력으로 자리매김할 것으로 전망된다.
용어해설
DRAM 컴퓨터나 스마트폰에서 현재 실행 중인 프로그램과 데이터를 임시로 저장하는 휘발성 메모리. 전원이 공급되는 동안만 데이터를 기억하며, 처리 속도가 매우 빨라 CPU가 연산 작업을 원활하게 수행할 수 있도록 돕는 핵심 부품
DDR 컴퓨터의 RAM(임시 저장 장치)이 데이터를 주고받는 속도를 높이기 위해 한 번의 클럭 사이클 내에 rising 및 falling 구간에서 각각 데이터를 전송하여 데이터 전송속도를 2배로 높이는 기술
JEDEC 반도체 메모리와 관련 장비의 국제 표준을 개발하고 제정하는 글로벌 표준화 단체. 제조사마다 다른 메모리 및 반도체 칩 규격을 통일하여 호환성을 보장하고, 고성능·고신뢰성 전자 제품이 시장에 유통되도록 관련 표준을 제정
LLM 방대한 양의 텍스트 데이터를 학습하여 인간의 언어를 이해, 분석, 생성하는 대규모 언어 모델(Large Language Model). 질문의 맥락을 파악하고 자연스러운 문장으로 답변하는 생성형 AI의 핵심 기반 기술
TSV 실리콘 칩을 수직으로 연결하는 실리콘 관통 전극 기술로, 여러 개의 반도체 칩을 3차원(3D)으로 적층하여 칩 간 신호와 전력을 전달하는 핵심 기술
온디바이스(On-Device) 외부 서버나 클라우드에 의존하지 않고, 스마트폰, PC 등 사용자 기기 자체에서 인공지능 연산과 데이터 처리를 직접 수행하는 기술
참고문헌
그림 1
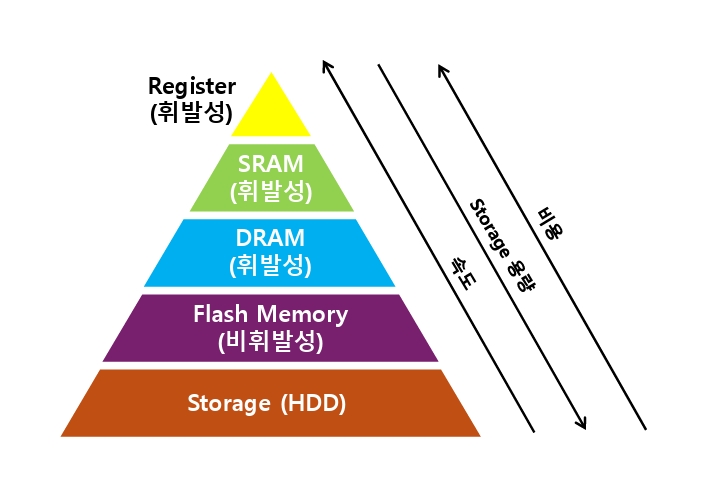
그림 2
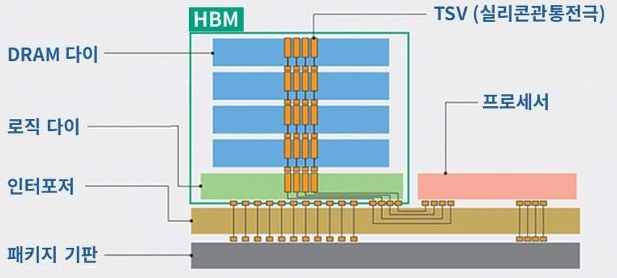
그림 3