AI 주권 시대의 정책 의사결정 지능 : Policy Intelligence의 개념과 참조 아키텍처
Policy Intelligence in the Era of Artificial Intelligence Sovereignty: A Conceptual Framework and Reference Architecture
- 저자
-
이연희정책지능연구센터 leeyh@etri.re.kr 강현중정책지능연구센터 kanghj@etri.re.kr 김영민정책지능연구센터 injesus@etri.re.kr 김현재정책지능연구센터 khjgo@etri.re.kr 유태완정책지능연구센터 twyou@etri.re.kr 이호성정책지능연구센터 hosung.lee@etri.re.kr 임완선정책지능연구센터 wslim@etri.re.kr 전종암정책지능연구센터 jajn@etri.re.kr 김태환정책지능연구센터 thkimetri@etri.re.kr 주현진정책지능연구센터 chooo@etri.re.kr 손시운정책지능연구센터 siwoonson@etri.re.kr 전상훈정책지능연구센터 jeon0123@etri.re.kr 윤도균정책지능연구센터 yoon@etri.re.kr 김다솔정책지능연구센터 dasolkim@etri.re.kr 김정선정책지능연구센터 jeongseon.kim@etri.re.kr 이강호정책지능연구센터 ianlee20@etri.re.kr 류상연정책지능연구센터 leoyeon@etri.re.kr
- 권호
- 41권 5호 (통권 222)
- 논문구분
- 인공지능컴퓨팅과 사이버 보안기술 동향
- 페이지
- 85-100
- 발행일자
- 2026.10.1
- DOI
- 10.22648/ETRI.2026.J.410508
 본 저작물은 공공누리 제4유형: 출처표시 + 상업적이용금지 + 변경금지 조건에 따라 이용할 수 있습니다.
- 초록
- The rapid advancement of generative artificial intelligence (AI) shifts global competition from individual model performance toward full-stack capabilities spanning semiconductors, computing infrastructure, data, foundation models, platforms, and services. Although public-sector AI supports administration, information retrieval, document generation, and citizen services, national policymaking requires integrated analysis of heterogeneous policy data and institutional constraints, forecasts of future conditions, and comparative evaluation of policy alternatives. Based on an analysis of policymaking requirements and AI full-stack capabilities, this article defines Policy Intelligence as an AI-enabled decision-support system that analyses policy data and environments, forecasts conditions, simulates effects, and generates and evaluates alternatives for human policymakers. It proposes a Policy Intelligence Reference Architecture (PIRA) integrating policy capabilities, a layered technology stack, a closed-loop workflow, and human-centered governance. The architecture provides a conceptual and technological bridge from a general-purpose AI full stack to national policy decision intelligence, supporting systematic and evidence-based policymaking.
Share
I. 서론
생성형 인공지능의 등장은 인공지능 기술 경쟁의 패러다임을 변화시키고 있다. 과거 인공지능 경쟁이 개별 알고리즘이나 모델의 성능 향상에 초점을 두었다면, 최근에는 AI 반도체, 컴퓨팅 인프라, 데이터, 기반모델, 플랫폼 및 응용서비스를 아우르는 AI 풀스택(AI Full Stack) 경쟁으로 빠르게 전환되고 있다. OECD는 신뢰할 수 있는 AI 생태계의 기반으로 데이터, AI 기술, 컴퓨팅 및 연결 인프라, 지식 공유 메커니즘을 포함하는 디지털 생태계를 강조하고 있으며[1], 국내에서도 AI 반도체, 모델, 클라우드 인프라와 산업 특화 솔루션을 결합한 AI 풀스택 협력 모델이 정책적으로 논의되고 있다[2]. 이러한 변화는 AI를 단순한 소프트웨어 기술이 아니라 국가의 핵심 전략 자산으로 인식하게 했으며, AI 주권(AI Sovereignty)을 주요 국가들의 정책 의제로 부상시키고 있다.
AI 주권은 자국의 AI 모델을 확보하는 것만을 의미하지 않는다. AI 서비스를 안정적으로 운영하기 위한 컴퓨팅 인프라와 데이터, 기반모델, 플랫폼 및 응용 생태계를 국가 스스로 구축하고 지속적으로 발전시킬 수 있는 역량을 포함한다. 그러나 AI 풀스택 전략과 공공부문의 AI 전환(Public AI Transformation)은 여전히 중요한 질문을 남긴다. 과연 AI를 보유하는 것만으로 국가의 정책 의사결정 역량까지 확보할 수 있는가?
현재 공공부문의 AI 활용은 공무원 업무지원, 민원응대, 문서작성, 정보검색 등 행정 효율화를 중심으로 빠르게 확산하고 있다. OECD/UNESCO의 공공부문 AI 툴킷은 AI가 내부 운영 효율성, 정책결정 효과성, 공공서비스 반응성, 투명성과 책임성 향상에 이바지할 수 있음을 제시한다[3]. 그러나 OECD의 2026년 디지털정부 전망은 정부 AI 활용이 내부 프로세스와 공공서비스에서 빠르게 확산되는 반면, 정책형성과 책무성 영역에서는 상대적으로 제한적임을 보여준다[4]. 실제로 OECD가 11개 정부 기능 영역의 200여 개 활용사례를 분석한 결과에서도 정부의 AI 활용은 내부 업무 자동화와 맞춤형 공공서비스, 부정수급 탐지 등에서 성과를 보이는 반면, 상당수 사업이 시범 단계에 머물러 있으며 인력과 데이터 거버넌스, 레거시 시스템 등의 제약에 직면해 있는 것으로 나타났다[5]. 이는 공공 AX가 행정 생산성과 서비스 품질 향상에는 기여하지만, 정책 의사결정 자체의 지능화를 위해서는 별도의 접근이 필요함을 시사한다.
국가의 정책 의사결정은 일반적인 행정업무와는 본질적으로 다른 특성을 가진다. 정책은 다양한 사회경제 데이터를 통합적으로 이해해야 하며, 법령과 제도적 제약을 고려해야 하고, 미래 환경을 예측하여 여러 정책대안의 효과를 비교‧평가해야 한다. 또한, 정책결정 과정은 결과뿐만 아니라 판단의 근거와 불확실성을 설명할 수 있어야 하며, 최종 책임은 인간 정책결정자에게 귀속된다. 따라서 단순한 챗봇, 문서 자동화, 정보검색 시스템만으로는 정책 의사결정에 요구되는 분석‧예측‧시뮬레이션‧설명 역량을 충분히 지원하기 어렵다.
본고에서는 공공 AX를 넘어 정책 의사결정 자체를 지능화하기 위한 AI 기반 의사결정 체계를 정책지능(Policy Intelligence)으로 정의한다. 정책지능은 정책 데이터를 이해하고, 정책환경을 분석하며, 미래를 예측하고, 정책효과를 시뮬레이션하고, 다양한 정책대안을 생성‧평가하여 정책결정자의 판단을 지원하는 AI 기반 의사결정 체계이다. 정책지능은 특정 AI 모델이나 단일 응용서비스가 아니라, AI 인프라, 정책 데이터, 정책 지식, AI 모델, 정책 시뮬레이션, AI 에이전트 및 정책 서비스를 하나의 구조로 통합하는 도메인 특화 의사결정 아키텍처로 이해할 필요가 있다.
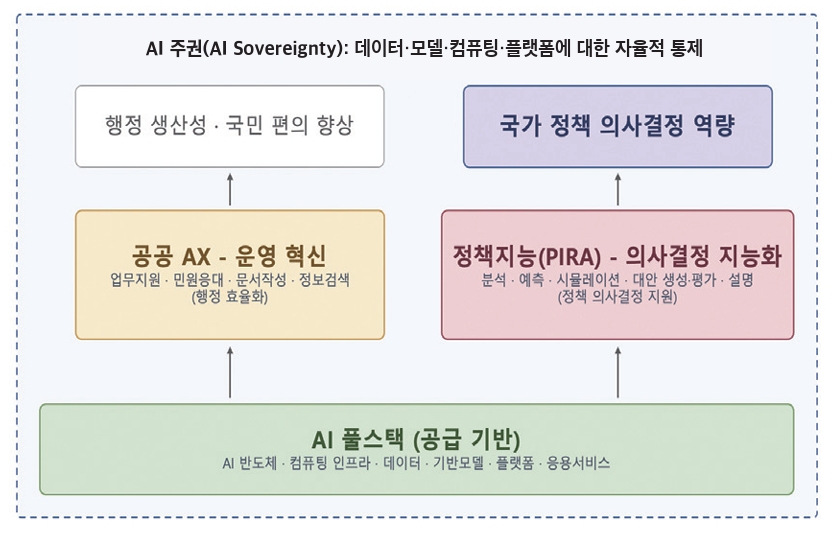
본고는 정책지능을 구현하기 위한 공통 개념틀로서 정책지능 참조 아키텍처(PIRA: Policy Intelligence Reference Architecture)를 제안한다. PIRA는 정책지능의 핵심 역량, 기술 스택, 정책 업무 흐름 및 거버넌스를 통합하여 AI 풀스택을 국가 정책 의사결정 역량으로 전환하는 연결 구조를 제공한다. AI 풀스택, 공공 AX 및 정책지능의 관계를 정리하면 그림 1과 같다.
본고의 구성은 다음과 같다. Ⅱ장에서는 정책지능의 개념과 핵심 역량을 정의하고, Ⅲ장에서는 PIRA의 기본 구조와 설계 원칙을 제안한다. Ⅳ장에서는 PIRA 구현을 위한 핵심 기술 동향을 살펴보고, Ⅴ장에서는 재정‧경제 분야 적용과 연구개발 과제를 논의한다. Ⅵ장에서는 본고의 논의를 종합하여 결론을 맺는다.
II. 정책지능의 개념과 핵심 역량
1. AI 풀스택, 공공 AX 및 정책지능의 관계
AI 풀스택은 인공지능을 개발‧학습‧배포‧운영하기 위한 공통 기반이며, 국가와 산업이 AI 기술을 자율적으로 활용하기 위한 공급 측면의 기술‧산업 기반이다. 공공 AX는 이러한 AI 풀스택을 바탕으로 공공부문의 업무와 서비스를 혁신하는 활용 영역이다. 반면 정책지능은 정책문제의 인식, 정책 환경 분석, 미래 예측, 정책대안 생성, 정책효과 분석, 근거 제시, 집행 모니터링 및 환류를 지원하는 의사결정 지능체계이다.
이를 정리하면 AI 풀스택은 국가 AI 역량의 기술 공급 기반, 공공 AX는 공공부문 업무와 서비스의 운영 혁신, 정책지능은 국가 정책 의사결정의 분석‧예측‧평가‧설명 역량을 담당한다. 따라서 정책지능은 AI 풀스택을 대체하는 개념이 아니라 AI 풀스택을 정책 의사결정 과정에 연결하는 상위 응용‧ 운영 구조이다.
2. 정책지능의 정의와 범위
본고에서 정책지능은 “정책 데이터와 지식을 바탕으로 정책환경을 인식하고, 미래 변화를 예측하며, 정책대안의 효과와 위험을 분석‧시뮬레이션하고, 그 결과의 근거와 불확실성을 설명함으로써 인간 정책결정자의 판단을 지원하는 AI 기반 의사결정 지능체계”라고 정의한다.
이 정의에서 중요한 점은 정책지능이 정책결정자를 대체하는 자동 의사결정 시스템이 아니라는 점이다. 공공정책은 사회적 가치, 정치적 책임, 법적 정당성, 예산 제약, 이해관계 조정, 분배효과 등 기술적 계산만으로 환원하기 어려운 요소를 포함한다. 따라서 정책지능은 인간 중심의 의사결정 지원 체계로 설계되어야 하며, OECD AI 원칙이 강조하는 인간 중심 가치와 감독 원칙[6], NIST AI RMF가 제시하는 위험관리 구조[7]를 정책 의사결정 맥락에서 반영해야 한다.
한편 데이터와 분석기법을 정책결정에 활용하려는 시도는 정책분석학(Policy Analytics), 정책모델링, 정책정보학(Policy Informatics) 등의 이름으로 이미 축적되어 왔다[8]. 이들은 계산적 사고와 복잡계 모델링, 데이터 분석을 공공문제 해결에 접목한다는 점에서 정책지능과 지향을 공유하지만, 주로 개별 분석기법의 적용과 방법론적 정교화에 초점을 두는 경향이 있다. 정책지능은 예측‧인과분석‧시뮬레이션‧대안생성‧설명 기능을 하나의 의사결정 아키텍처로 통합하고, 이를 정책 업무 흐름 및 책임체계와 연결한다는 점에서 차이가 있다. 또한, Gov-Tech는 민간이 개발‧운영하는 사회기술적 솔루션이 공공부문 프로세스와 결합되는 현상을 가리키며 주로 서비스 전달과 조달‧생태계 관점에서 논의되고[9], RegTech는 규제 준수와 규제 집행의 기술적 지원에 초점을 둔다[10]. 두 개념 모두 행정‧규제 절차의 디지털화에 무게가 있어 정책대안의 형성과 평가라는 의사결정의 상류 과정을 직접 다루지는 않는다.
계산사회과학(Computational Social Science)[11]과 사회 디지털 트윈[12]은 사회현상을 대규모 데이터와 정량 모형으로 관측‧재현‧예측한다는 점에서 정책지능의 분석 기반과 직접 맞닿아 있다. 그러나 이들의 일차적 목표는 현상의 이해와 예측이며, 정책대안의 생성‧비교와 근거 설명, 집행 환류까지를 하나의 운영체계로 묶는 것은 별도의 설계 문제로 남는다.
최근에는 디지털 공공인프라, Data-for-Policy, 알고리즘 정부, GovTech를 네 계층으로 통합해 AI 기반 국가 전환을 설명하려는 시도도 제시되었으나[13], 이는 정부 전반의 전환을 조망하는 거시 프레임워크로서 정책 의사결정이라는 특정 기능을 구현하기 위해 어떤 역량과 기술 구성요소가 필요한지를 구체화하는 데까지는 이르지 않는다. 정책지능은 이 지점을 좁고 깊게 다루는 도메인 특화 개념으로 위치한다.
3. 정책지능 핵심역량
정책지능을 구현하기 위해서는 정책 의사결정 과정에서 요구되는 지능 역량을 먼저 정의할 필요가 있다. 본고에서는 정책지능의 핵심 역량을 정책 이해, 상황인식, 미래 예측, 효과 분석‧시뮬레이션, 대안 생성‧평가, 근거 제시‧설명, 실행 모니터링‧학습의 일곱 가지로 구분한다. 각 역량의 주요 기능과 이를 구현하는 관련 기술을 정리하면 표 1과 같다.
표 1 정책지능 핵심 역량과 관련 기술
정책 이해 역량은 법령, 제도, 정책문서, 통계 및 과거 정책사례를 종합적으로 해석하는 능력이다. 상황인식 역량은 경제‧사회‧산업‧인구 등 다양한 출처의 데이터를 통합하여 현재 정책 환경을 파악하는 능력이다. 미래 예측 역량은 주요 정책 변수와 위험 요인의 변화를 전망하는 능력이며, 효과 분석‧시뮬레이션 역량은 정책대안이 시행되었을 때 발생할 수 있는 직접‧간접‧분배‧동태적 효과를 사전에 분석하는 능력이다.
대안 생성‧평가 역량은 주어진 정책목표와 제약 조건에 따라 복수의 정책 수단과 시나리오를 생성하고 비교하는 능력이다. 근거 제시‧설명 역량은 분석 결과의 데이터, 가정, 모델, 불확실성 및 한계를 정책결정자가 이해할 수 있도록 설명하는 능력이다. 실행 모니터링‧학습 역량은 정책 집행 이후 실제 결과를 추적하고, 이를 다시 데이터와 모델에 반영하여 정책지능을 지속적으로 갱신하는 능력이다.
III. 정책지능 참조 아키텍처
1. 참조 아키텍처의 필요성과 설계 원칙
정책지능은 특정 인공지능 모델이나 단일 응용서비스로 구현되기 어렵다. 정책 의사결정은 정책문제의 인식, 데이터 수집과 통합, 정책 맥락 이해, 미래 예측, 정책대안 생성, 정책효과 분석, 의사결정 지원, 집행 모니터링 및 환류를 포함하는 복합적 과정이기 때문이다. 따라서 정책지능을 구현하기 위해서는 정책 의사결정에 필요한 핵심 역량을 정의하고 이를 데이터, 지식, 모델, 시뮬레이션, 에이전트, 서비스 및 거버넌스 구조와 연결하는 통합적 참조체계가 필요하다.
소프트웨어‧시스템 아키텍처 분야에서는 복잡한 시스템을 설명하기 위해 이해관계자의 관심사를 반영한 복수의 관점과 뷰를 사용하는 접근이 일반적이다. ISO/IEC/IEEE 42010은 아키텍처 기술에서 아키텍처 관점, 모델 종류, 관계를 활용하여 시스템을 설명하는 요구사항을 제시한다[14]. 또한, TOGAF는 엔터프라이즈 아키텍처를 통해 비즈니스, 데이터, 애플리케이션, 기술 영역을 정렬하는 구조적 접근을 제공한다[15]. 한편, 참조 아키텍처는 특정 제품의 구현 명세가 아니라 해당 응용 도메인에서 검증된 구조의 본질을 추출해 구체적 시스템 아키텍처의 개발과 표준화, 진화를 안내하는 일반적 도식으로, 이해관계자 간에 공통의 어휘와 분류 체계를 제공하고 여러 조직과 연구개발 활동이 공유할 수 있는 기준선을 만들어 준다는 데 그 효용이 있다[16]. 본고의 PIRA도 이러한 성격을 지향하며, 분산되어 있는 정책 AI 기술과 연구개발 활동을 정책 의사결정의 관점에서 체계화하기 위한 개념적 참조틀이다. 정책지능 역시 국가 정책 의사결정이라는 복합 시스템을 대상으로 하므로, 단일 기술 스택이 아니라 복수 관점을 통합한 참조 아키텍처로 설계되어야 한다.
본고의 PIRA는 정책문제 중심성, 데이터‧지식‧모델 통합, 예측과 시뮬레이션의 결합, 인간 중심 의사결정, 설명 가능성과 감사 가능성, 보안성과 주권성, 지속적 학습과 환류를 설계 원칙으로 한다. 특히 정책지능은 정책결정자를 대체하기보다 정책 결정자의 판단을 지원해야 하며, 분석 결과의 근거와 한계를 설명하고 검증할 수 있어야 한다.
2. PIRA의 네 가지 관점
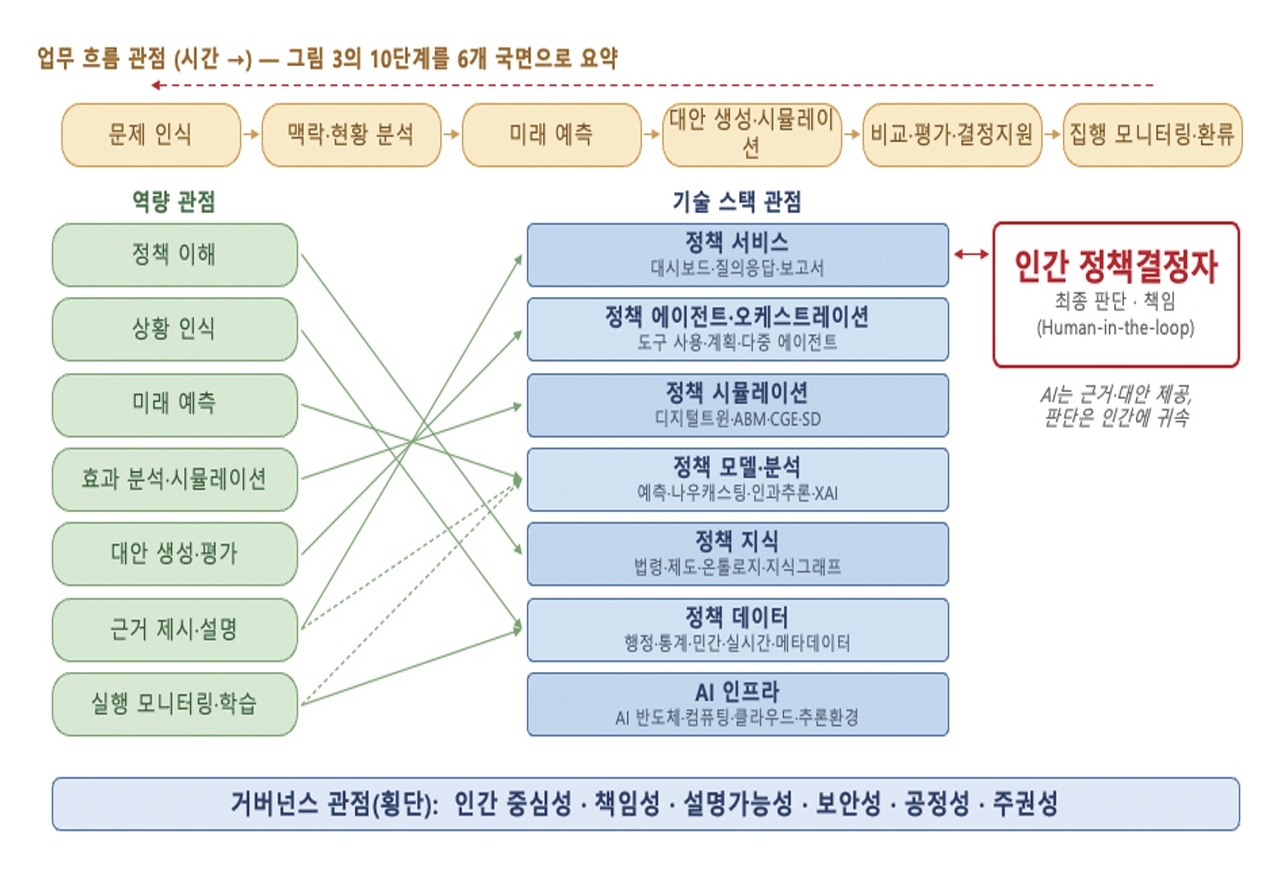
PIRA는 정책지능을 네 가지 관점에서 설명한다. 역량 관점(Capability View)은 정책 의사결정을 지원하기 위해 정책지능이 갖추어야 할 기능적 능력을 정의한다. 기술 스택 관점(Stack View)은 이러한 역량을 구현하기 위한 데이터, 지식, 모델, 시뮬레이션, 에이전트 및 서비스 계층을 설명한다. 업무 흐름 관점(Workflow View)은 정책문제 인식부터 집행 모니터링과 학습에 이르는 정책지능의 작동 절차를 제시한다. 거버넌스 관점(Governance View)은 정책지능이 인간 중심성, 책임성, 설명 가능성, 보안성, 공정성 및 주권성을 확보하기 위해 따라야 할 운영 원칙과 통제 구조를 정의한다. 이상의 네 가지 관점과 그 상호관계를 도식화하면 그림 2와 같다.
3. 기술 스택 관점
기술 스택 관점은 정책지능의 핵심 역량을 구현하기 위한 시스템 구성요소를 계층적으로 설명한다. 본고에서는 정책지능 기술 스택을 AI 인프라, 정책 데이터, 정책 지식, 정책 모델‧분석, 정책 시뮬레이션, 정책 에이전트‧오케스트레이션, 정책 서비스 계층으로 구분한다. 각 계층의 주요 구성요소와 핵심역할은 표 2와 같다.
표 2 PIRA의 기술 스택 계층
AI 인프라 계층은 계산, 저장, 네트워크 및 모델 실행 기반을 제공한다. 정책 데이터 계층은 다양한 정책 데이터를 수집‧저장‧통합‧품질관리하며, 정책 지식 계층은 법령, 제도, 정책문서, 행정규칙, 예산제도, 정책사례를 구조화한다. 정책 모델‧분석 계층은 현재 상황을 분석하고 미래 변화를 예측하며, 정책 시뮬레이션 계층은 정책대안의 효과를 사전에 실험하고 평가한다.
정책 에이전트‧오케스트레이션 계층은 여러 구성요소를 목적 지향적으로 연결하고 실행한다. 정책 서비스 계층은 정책결정자, 분석가, 공무원 및 전문가가 정책지능 기능을 활용하는 사용자 접점이다. 이 계층은 단순한 시각화 화면을 넘어, 정책결정자가 분석 결과의 근거와 불확실성을 이해하고 대안을 비교할 수 있도록 설계되어야 한다.
4. 업무 흐름과 거버넌스 관점
PIRA의 정책 업무 흐름은 선형 절차가 아니라 정책 집행 결과가 다시 데이터, 지식, 모델 및 정책대안에 반영되는 순환구조이다. 기본 흐름은 정책문제 인식, 정책 맥락 이해, 데이터 통합 및 현황 분석, 미래 환경 예측, 정책대안 생성, 정책효과 시뮬레이션, 대안 비교‧평가, 근거 제시와 의사결정 지원, 정책 집행 모니터링, 데이터‧모델‧정책지식 갱신으로 구성된다. 이 10단계는 그림 3에 순환 구조로 표현하였으며, 그림 2의 업무 흐름 관점에서는 문제 인식, 맥락‧현황 분석, 미래 예측, 대안 생성‧시뮬레이션, 비교‧평가‧결정지원, 집행 모니터링‧환류의 6개 국면으로 요약하여 나타내었다.
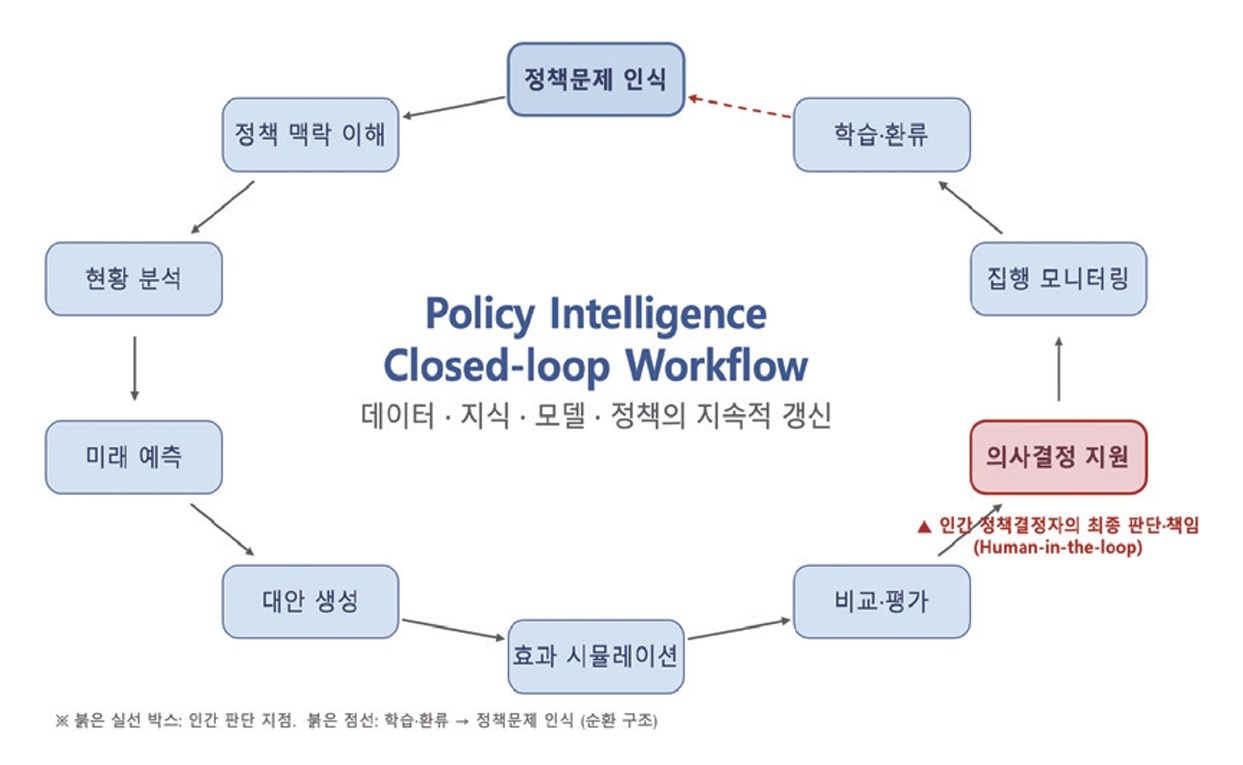
이러한 순환 구조는 의제설정, 정책형성, 정책결정, 집행, 평가의 단계를 거쳐 평가 결과가 다시 의제설정으로 환류되는 정책학의 정책순환 모형[17]과 대응되며, 정책지능은 각 단계의 실제 산출물(정책보고서, 대안 비교표, 예산 추계, 집행 실적 등)과 결합될 때 비로소 작동한다. 이러한 순환 구조를 도식화하면 그림 3과 같다.
거버넌스는 PIRA의 모든 계층과 업무 흐름에 횡단적으로 적용되는 통제 구조이다. 정책지능은 국민의 권리와 의무, 재정 배분, 사회적 형평성 및 국가 전략에 영향을 미칠 수 있기 때문에 일반적인 AI 서비스보다 높은 수준의 책임성과 신뢰성이 요구된다. 따라서 인간 중심성과 최종 책임성, 데이터와 모델의 출처 추적성, 설명 가능성과 불확실성 제시, 위험 기반 관리, 보안과 접근권한 관리, 공정성과 편향 점검, AI 주권과 운영 독립성이 거버넌스 요소로 포함되어야 한다.
EU AI Act는 고위험 AI 시스템에 대해 데이터 품질, 로그 기록, 문서화, 사용자 정보 제공, 인간 감독, 견고성, 사이버보안 및 정확성 등을 요구한다[18]. 정책지능에서도 기능의 영향도와 위험 수준에 따라 차등화된 검증과 승인 절차가 필요하다. 특히 복지, 조세, 치안, 규제와 같이 국민의 권리와 의무에 직접 영향을 미칠 수 있는 정책 분야에서는 인간 감독과 감사 가능성을 시스템 설계 단계부터 내재화해야 한다. 다만, 거버넌스 관점이 규정하는 것은 “무엇을 지켜야 하는가”에 관한 원칙과 절차이며, 그 원칙을 실제로 구현하는 기술은 Ⅳ장 5절에서 별도로 다룬다. 원칙과 구현 기술을 구분하는 것은 거버넌스 요구사항이 특정 기술의 도입 여부로 환원되어 형식적 준수에 그치는 것을 피하기 위함이다.
IV. 정책지능 구현을 위한 핵심 기술 동향
1. 정책 데이터·지식 기반 기술
정책지능의 출발점은 정책 의사결정에 필요한 데이터를 안정적으로 수집‧연계‧활용할 수 있는 데이터 기반이다. 정책 데이터는 통계자료, 행정자료, 예산‧재정자료, 공간정보, 민간데이터, 실시간 데이터, 문서자료 등 다양한 형태로 존재한다. 따라서 정책지능 시스템은 특정 데이터베이스나 단일 기관의 데이터에 의존하기보다 다양한 출처의 데이터를 의미적으로 연결하고 품질을 관리할 수 있는 데이터 패브릭 또는 데이터 허브 구조를 필요로 한다.
FAIR 원칙은 데이터가 사람뿐만 아니라 기계도 자동으로 찾고 사용할 수 있도록 Findable, Accessible, Interoperable, Reusable해야 함을 강조한다[19]. 정책지능에서도 데이터의 출처, 의미, 갱신주기, 품질, 사용조건, 계보가 기계가 이해할 수 있는 형태로 관리되어야 한다. 통계 데이터와 메타데이터의 표준화 측면에서는 SDMX가 통계 데이터와 메타데이터를 설명하고 교환‧공유하기 위한 국제표준으로 활용될 수 있다[20]. 여기에 더해 정책 데이터에는 시점 정합성 관리가 요구된다. 통계는 확정‧잠정 시점이 다르고 법령은 개정 이력을 가지므로, 특정 시점의 정책환경을 재현하기 위해서는 데이터와 제도 규칙에 대한 시계열적 버전 관리가 필요하다.
정책 의사결정은 수치 데이터만으로 이루어지지 않는다. 법령, 행정규칙, 정책문서, 예산 설명자료, 국회자료, 연구보고서, 평가보고서, 언론자료, 과거 정책사례 등 다양한 비정형 지식이 함께 활용된다. 지식그래프는 다양한 데이터와 지식을 개체와 관계의 형태로 표현하여 복잡한 데이터 컬렉션을 활용하는 데 유용하다[21]. 정책 분야에서는 정책목표, 정책수단, 법령 조항, 예산사업, 대상 집단, 성과지표, 관련 기관, 정책효과, 위험 요인 간의 관계를 구조화할 수 있다.
대규모 언어모델은 정책문서 요약, 정책 질의응답, 보고서 작성, 정책대안 생성 등 다양한 업무를 지원할 수 있다. 그러나 정책 분야에서는 최신성, 정확성, 출처 추적성이 중요하므로 모델 내부 지식만을 활용한 응답은 한계를 가진다. 검색증강생성(RAG: Retrieval-Augmented Generation)은 외부 지식 저장소에서 관련 문서를 검색한 후 검색된 내용을 기반으로 답변을 생성하는 접근으로, 지식집약적 과제에서 근거성과 최신성을 높일 수 있다[22,23]. 또한, GraphRAG는 문서에서 엔티티와 관계를 추출하여 그래프 인덱스를 구성하고, 전체 코퍼스 수준의 복합 질의에 대응하는 접근으로 제안되었다[24]. 정책문서가 상호 참조 구조를 갖고 법령‧예산‧사업이 계층적으로 연결되어 있다는 점에서 이러한 구조 인식형 접근은 정책 지식베이스 구축에 직접적인 시사점을 준다.
2. 예측·인과·설명 기술
정책 의사결정은 미래지향적이다. 정책결정자는 현재의 경제‧사회 상황뿐만 아니라 성장률, 물가, 고용, 세수, 재정수지, 인구, 산업생산, 에너지 수요 등 주요 정책변수의 향후 변화를 고려해야 한다. 최근에는 대규모 시계열 데이터를 사전학습하여 다양한 예측 문제에 적용할 수 있는 시계열 기반 모델에 관한 연구가 활발하다[25]. TimesFM은 대규모 시계열 코퍼스에 사전학습된 디코더 전용 예측 모델로 제안되었고[26], Chronos는 시계열 값을 토큰화하여 언어모델 아키텍처로 학습하는 확률적 예측 프레임워크를 제시하였다[27].
다만, 시계열 기반모델의 성능 평가에 대해서는 벤치마크 설계와 데이터 누출, 평가 지표의 타당성 등에 관한 문제 제기도 함께 이루어지고 있다[28]. 특히 GDP 나우캐스팅을 대상으로 한 최근 비교연구는 전통적 계량모형이 여전히 경쟁력을 유지하며, 기계학습 계열 중에서는 Lasso‧Elastic Net과 같은 선형 계열이 상대적으로 우수한 반면, 비선형 모형은 시계열 표본이 짧아 과적합에 취약하다는 결과를 보고하였다[29]. 따라서 정책지능의 예측 구성 요소는 AI 모형으로 기존 모형을 대체하기보다 복수 모형의 병행 운용과 예측 구간의 제시, 예측 오차의 사후 추적을 표준 절차로 삼는 방향이 타당하다.
정책지능에서 예측은 “앞으로 어떤 일이 일어날 것인가”를 다루는 반면, 인과추론은 “특정 정책을 시행하면 어떤 변화가 발생하는가”를 다룬다. Pearl은 전통적인 통계분석에서 인과분석으로 전환하기 위해서는 인과 가정, 반사실적 주장, 구조적 인과모형의 언어가 필요하다고 설명하였다[30]. 최근 정책평가에서는 고차원 공변량하에서 기계학습을 활용하면서도 편의를 제거해 평균처치효과를 추정하는 이중기계학습(DML: Double/Debiased Machine Learning)[31]과 하위집단별 효과의 이질성을 추정하는 인과 포레스트(Causal Forest) 계열의 방법[32]이 널리 활용되고 있다.
계층‧지역‧산업별 분배효과를 파악해야 하는 정책 의사결정의 요구를 고려하면, 평균효과보다 이질적 처치효과의 추정이 오히려 더 중요한 경우가 많다. 다만, 이러한 방법에 사용되는 모델이 전역적으로 해석 가능한 형태가 아니어서 추정 결과가 어떤 경로로 산출되었는지 설명하기 어렵고, 이는 결과의 활용성과 책임성을 함께 제약한다는 지적이 제기되고 있다[33]. 정책지능에서는 인과추론을 활용하여 과거 정책의 효과를 평가하고, 특정 정책대안이 시행되었을 때의 반사실적 결과를 추정하며, 예측모형과 시뮬레이션 모형의 결과를 인과적 설명으로 변환할 수 있다.
설명가능 AI(XAI: eXplainable AI)는 정책지능의 핵심 기술 중 하나이다. SHAP는 예측 결과에 대한 각 특성의 기여도를 샤플리 값 기반으로 해석하는 대표적인 방법으로 제안되었다[34]. 정책지능에서는 XAI를 활용하여 특정 예측 결과가 어떤 변수에 의해 도출되었는지, 어떤 요인이 정책효과에 가장 큰 영향을 미쳤는지, 특정 정책대안이 왜 우선순위가 높게 평가되었는지 설명할 수 있다. 다만, 정책 설명은 단순한 변수 중요도 제시에 그쳐서는 안 되며, 데이터 출처, 분석 가정, 모델 구조, 시나리오 조건, 인과 가정, 불확실성 범위를 함께 제시해야 한다. 나아가 고위험 의사결정에서는 사후 설명이 원 모델의 판단 과정을 충실히 반영하지 못할 수 있으므로 본질적으로 해석 가능한 모델을 우선 사용해야 한다는 비판도 제기되어 왔다[35]. 정책 근거의 검증 가능성이 요구되는 정책지능에서는 예측 정확도만을 기준으로 모델을 선택하기보다 설명 요구 수준에 따라 모델 유형을 달리 선택하는 설계 판단이 필요하다.
3. 정책 시뮬레이션·최적화 기술
디지털 트윈은 현실 시스템을 가상공간에 표현하고, 현실 데이터와 지속적으로 연계하여 분석과 의사결정을 지원하는 개념으로 확장되고 있다. 디지털 트윈 정의 연구에서는 디지털 트윈을 갱신 메커니즘을 가진 개방형 동역학 시스템으로 설명하고, 디지털 트윈 시스템이 데이터 분석과 의사결정 기능을 포함할 수 있음을 제시하였다[36]. 정책 디지털 트윈은 단순한 시뮬레이션 모형이 아니라 현실 정책환경과 지속적으로 동기화되며, 정책대안의 효과를 실험하고 결과를 환류하는 체계로 이해할 수 있다.
정책효과는 개인, 가구, 기업, 산업, 금융기관, 정부 등 다양한 행위자의 상호작용을 통해 나타나므로 단일 평균값으로 설명되기 어렵다. 에이전트 기반 모델링(ABM: Agent-Based Model)은 행위자 이질성과 상호작용, 네트워크 효과, 시간 지연 효과를 분석하는 데 유용하다. Poledna 등은 국민계정, 산업 계정, 산업연관표, 정부통계, 인구‧기업통계 등 미시‧거시 데이터를 활용한 ABM이 거시변수 예측과 정책효과 분석에 활용될 수 있음을 보였다[37].
한편, 조세‧급여 제도와 같이 제도 규칙이 명시적으로 정의된 영역에서는 가구 단위 미시데이터에 제도규칙을 적용하여 소득분포와 불평등, 근로 유인에 대한 영향을 산출하는 미시모의실험(Microsimulation)이 이미 정책분석의 표준 도구로 활용되고 있다[38]. 연산일반균형(CGE: Computable General Equilibrium) 모형은 부문 간 파급효과와 상대가격 변화를 정합적으로 다루는 데 강점이 있는 반면, 미시모의실험은 개별 가구‧기업 단위의 분배효과를 세밀하게 포착하는 데 강점이 있다. 따라서 정책 시뮬레이션 계층은 단일 모형이 아니라 CGE, ABM, 미시모의실험을 상호 보완적으로 연계하는 구조로 설계될 필요가 있으며, 이때 제도 규칙의 정확한 반영이 결과의 타당성을 좌우하므로 정책 지식 계층의 법령 구조화가 선행 조건이 된다.
강화학습은 환경과의 상호작용을 통해 장기 보상을 극대화하는 행동정책을 학습하는 방법으로, 정책대안 탐색과 최적화에 활용될 수 있다. AI Economist는 에이전트와 사회계획자(Social Planner)가 함께 적응하는 2수준 심층 강화학습 구조를 통해 조세정책 설계를 실험하였다[39]. 다만, 실제 정책 의사결정에 강화학습을 적용할 때는 정책목표의 다원성, 시뮬레이션-현실 간 격차, 설명 가능성, 인간 감독을 함께 고려해야 한다. 따라서 강화학습은 자동 정책결정 도구가 아니라 정책 시뮬레이션 환경에서 다양한 대안을 탐색하고 Trade-Off를 제시하는 보조 기술로 위치시켜야 한다.
4. AI 에이전트·오케스트레이션 기술
최근 대규모 언어모델의 발전은 단순 질의응답을 넘어 외부 도구를 호출하고, 계획을 수립하며, 작업을 단계적으로 수행하는 AI 에이전트 기술로 확장되고 있다. ReAct는 언어모델이 추론과 행동을 교차적으로 생성하도록 하여 외부 지식원이나 환경과 상호작용을 하면서 문제를 해결하는 접근을 제안하였다[40]. Toolformer는 언어모델이 계산기, 검색엔진, 번역기, 달력 등 외부 API를 언제, 어떻게 호출할지 학습할 수 있음을 보였다[41].
정책지능에서 AI 에이전트는 정책문제 분석, 자료 검색, 데이터 조회, 예측모형 실행, 시뮬레이션 호출, 정책대안 생성, 평가 결과 요약, 보고서 작성 등을 연결하는 오케스트레이션 역할을 수행할 수 있다. 복잡한 정책문제에서는 단일 에이전트보다 데이터 분석 에이전트, 법령‧제도 검토 에이전트, 예측 에이전트, 시뮬레이션 에이전트, 대안 생성 에이전트, 설명‧보고 에이전트가 협력하는 다중 에이전트 구조가 적합할 수 있다. 생성형 에이전트 연구는 LLM 기반 에이전트가 기억, 반성, 계획 기능을 통해 개별 및 집단 행동을 모사할 수 있음을 보여주었다[42].
다만, 정책 에이전트는 일반적인 업무 자동화 에이전트보다 높은 수준의 검증이 필요하다. 정책 에이전트가 잘못된 데이터를 조회하거나, 부적절한 모델을 호출하거나, 정책문서를 잘못 해석하면 잘못된 정책 판단을 유도할 수 있다. 따라서 정책 에이전트에는 도구 호출 권한 관리, 실행 전 승인, 결과 검증, 로그 기록, 인간 검토 절차가 결합되어야 한다. 그러나 에이전트의 평가 방법론 자체가 아직 정립 단계에 있어, 계획 수립과 도구 사용의 정확성 및 다단계 작업의 신뢰성을 어떻게 측정할 것인지에 관한 논의가 진행 중이다[43]. 공공 의사결정 맥락에서는 중간 단계의 오류가 최종 판단으로 전파되는 문제와 작업 이력의 감사 가능성이 추가 요구사항으로 제기되므로, 자율성의 수준을 과제별로 제한하는 설계가 요구된다.
5. 신뢰·보안·주권형 운영 기술
본 절은 Ⅲ장 4절에서 제시한 거버넌스 관점의 원칙을 실제로 구현하는 기술을 다룬다. 정책지능은 일반적인 AI 서비스보다 높은 수준의 신뢰성과 위험관리를 요구한다. 정책지능의 결과는 예산 배분, 조세, 복지, 산업지원, 규제, 안전, 치안, 환경 등 국민 생활과 국가 운영에 직접적인 영향을 미칠 수 있기 때문이다. NIST AI RMF는 AI 시스템의 위험을 관리하기 위한 기능으로 Govern, Map, Measure, Manage를 제시하며[7], 정책지능도 목적과 사용 맥락을 정의하고 데이터‧모델‧에이전트의 위험을 식별‧측정‧관리하는 체계를 갖추어야 한다.
정책지능은 민감한 행정자료와 정책 분석결과를 다룰 가능성이 높다. 따라서 데이터 보안, 개인정보 보호, 접근권한 관리, 모델 보안, 감사 로그, 비식별화, 안전한 연합분석 등의 기술이 필요하다. 데이터 보호의 이론적 기반으로는 개별 개체의 정보가 결과에 미치는 영향을 수학적으로 제한하는 차분 프라이버시가 활용되며[44], 이는 공적 통계 생산에도 실제로 도입되어 통계 공표 방식의 전환을 가져왔다[45]. 다만, 합성 미시데이터는 생성 모형에 명시적으로 반영된 변수 간 관계만을 보존하므로, 사전에 예상하지 못한 관계를 탐색해야 하는 정책 분석에는 제약이 따른다는 점이 함께 지적된다. 특히 AI 에이전트가 데이터베이스, 문서저장소, 시뮬레이션 도구, 보고서 생성도구를 호출하는 구조에서는 권한 오남용이나 오류 전파 위험이 커질 수 있으므로, 에이전트별 권한, 사용 가능한 도구, 호출 가능한 데이터 범위, 승인 절차를 세밀하게 관리해야 한다.
AI 주권 관점에서는 정책지능의 핵심 데이터, 모델, 컴퓨팅 자원, 운영 플랫폼에 대한 통제권도 중요하다. 외부 상용 모델이나 클라우드 서비스를 활용할 수 있지만, 민감도와 중요도에 따라 자체 모델, 공개모델, 상용모델, 온프레미스 인프라, 클라우드 인프라를 조합하고 핵심 정책 데이터와 의사결정 기능에 대한 통제권을 확보해야 한다. 이는 AI 풀스택을 국가 정책 의사결정 역량으로 전환하기 위한 핵심 조건이다.
V. 재정·경제 정책지능 적용과 연구개발 과제
1. 재정·경제 정책지능의 적용 구조
재정‧경제 분야는 정책지능의 대표적인 적용 영역이다. 재정정책과 경제정책은 조세, 재정지출, 부채, 성장, 물가, 고용, 소득분배, 산업구조, 금융안정 등 다양한 정책변수와 연결되며, 정책 시행 결과가 사회 전반에 광범위한 영향을 미친다. 또한, 정책결 정자는 현재의 경제상황을 진단하는 것뿐만 아니라 미래 경제환경을 예측하고, 복수의 정책대안이 가져올 거시경제적 효과, 재정소요, 세수 변화, 분배효과 및 잠재적 부작용을 비교해야 한다. 정량 데이터가 상대적으로 풍부하고 정량 모형에 기반한 정책 분석 전통이 이미 확립되어 있으며, 예산 편성이라는 명확한 연간 의사결정 주기가 존재한다는 점도이 분야가 정책지능의 대표 적용영역으로 적합한 조건이다.
생성형 AI의 확산은 재정‧경제정책에도 새로운 과제를 제기한다. IMF는 AI 전환이 생산성 향상과 공공서비스 개선 가능성을 제공하지만, 노동시장 충격과 불평등 확대 가능성을 함께 제기하므로 사회보호와 조세체계의 정책적 대응이 중요하다고 지적하였다[46]. 국제결제은행(Bank for International Settlements)은 AI가 생산성, 투자, 소비, 임금, 인플레이션 및 금융안정에 영향을 줄 수 있으므로 중앙은행과 정책기관이 AI와 비전통 데이터를 분석 도구에 통합할 필요가 있다고 논의하였다[47].
PIRA 기반 재정‧경제 정책지능은 재정‧경제 데이터 계층, 정책 지식 계층, 예측‧분석 계층, 경제 디지털 트윈과 정책 시뮬레이션 계층, 정책 에이전트‧오케스트레이션 계층, 정책 서비스 계층 및 거버넌스 계층으로 구성될 수 있다. 이를 통해 세수 전망, 조세정책 효과분석, 재정지출 효과분석, 거시경제 충격 대응, AI 전환에 따른 노동시장‧재정정책 분석 등을 지원할 수 있다. PIRA 계층별 재정‧경제 분야 구성요소와 주요 기능을 정리하면 표 3과 같다.
표 3 PIRA 기반 재정·경제 정책지능 구성
2. 주요 활용 시나리오
첫째, 세수 전망과 조세정책 효과분석이다. 세수는 경제성장률, 물가, 고용, 임금, 기업이익, 소비, 자산시장, 수입, 제도 변화 등 다양한 변수에 영향받는다. 정책지능은 공식통계와 행정자료, 기업‧가계 데이터, 고빈도 경제지표를 결합하여 세수 전망의 신속성과 정확성을 높일 수 있다. 다만, 앞서 살펴본 바와 같이 거시지표 나우캐스팅에서는 전통적 계량 모형이 여전히 경쟁력을 유지하고 있으므로[29], 단일 모형에 의존하기보다 복수 모형을 병행 운용하고 전망 구간과 오차를 함께 제시하는 방식이 요구된다. 조세정책 효과분석에서는 세율, 공제‧감면, 과세표준, 납세자 유형, 경제행위 변화를 함께 고려하여 세수효과와 분배효과를 추정할 수 있다. 이때 조세‧급여 제도의 규칙을 가구 단위 미시데이터에 적용하는 미시모의실험[38]을 정책 에이전트가 호출 가능한 분석 구성요소로 편입하면, 제도 변경안의 생성과 복수 대안의 비교, 결과 서술의 정리를 하나의 흐름으로 연결할 수 있다.
둘째, 재정지출 효과분석과 예산 배분이다. 정책 지능은 예산사업별 목적, 대상, 집행실적, 성과지표, 지역‧계층별 수혜 정보를 통합하여 재정지출의 효과를 분석할 수 있다. 또한, 유사사업 비교, 중복사업 탐지, 집행률 이상 징후 탐지, 성과 기반 예산배분 지원에도 활용될 수 있다. 개별 사업의 처치효과와 그 이질성을 추정하는 데는 Ⅳ장 2절의 인과 기계학습 기법이 직접 적용되며, 동시에 추정 결과의 투명성 확보[33]가 재정당국의 실제 활용 가능성을 결정하는 관건이 된다.
셋째, 거시경제 충격 대응과 재정건전성 분석이다. 팬데믹, 금융불안, 공급망 충격, 에너지 가격 급등, 인구구조 변화, 기술전환 등은 재정‧경제정책에 큰 불확실성을 가져온다. 정책지능은 이러한 충격을 조기에 탐지하고 성장률, 물가, 고용, 세수, 재정수지, 국가채무에 미치는 영향을 시나리오별로 분석할 수 있다.
넷째, AI 전환에 따른 재정‧노동시장 정책 분석이다. AI 확산은 생산성 향상과 신산업 창출을 가능하게 하지만 노동시장 대체, 소득불평등, 교육‧훈련 수요 증가, 조세기반 변화 등 새로운 정책문제를 유발할 수 있다. 정책지능은 직무별 AI 노출도와 고용자료를 결합하여 산업‧직종별 전환 위험을 분석하고, 교육훈련 투자, 사회보험, 조세정책, 산업정책 등 대안을 시뮬레이션할 수 있다.
다섯째, 조세행정 집행 결과의 정책 환류이다. 이미 다수의 조세행정기관이 위험평가와 부정 탐지에 AI를 활용하고 있으며, 패턴 분석을 통한 탈루 탐지와 환급 부정 적출 등이 주요 용도로 보고된다[48]. 이 영역은 정책 결정보다 집행에 가까우므로, 정책 지능 관점에서는 집행 결과 데이터를 정책 설계로 되돌리는 환류 경로로 위치시키는 것이 적절하다. 동시에 알고리즘 편향과 판단 근거의 불투명성, 프라이버시 침해 위험이 함께 지적되고 있어 거버넌스 요구사항이 가장 엄격하게 적용되어야 하는 영역이기도 하다[48].
3. 향후 연구개발 과제
재정‧경제 정책지능과 PIRA를 실질적인 정책 의사결정 체계로 발전시키기 위해서는 다음과 같은 연구개발 과제가 필요하다. 추진 시기에 따른 단계적 구성은 표 4와 같으며, 단기‧중기‧장기 과제를 관통하는 여섯 가지 세부 과제를 제시한다.
표 4 정책지능 연구개발 로드맵
첫 번째 과제는 정책 특화 기반모델과 정책 지식체계 구축이다. 범용 LLM은 일반 문서 이해와 생성에 유용하지만, 법령, 예산, 통계, 정책평가, 행정절차, 경제모형, 조세제도와 같은 정책 전문지식을 충분히 반영하기 어렵다. 따라서 정책문서, 법령, 통계 메타데이터, 예산자료, 정책평가보고서, 국회자료, 국제기구 보고서를 기반으로 정책 도메인에 특화된 언어모델, 임베딩 모델, 지식그래프, 정책 온톨로지를 구축할 필요가 있다. 이때 개정 이력과 확정‧잠정 시점을 함께 관리하는 시점 인식형 지식베이스 설계와 부처 간 데이터 연계의 제도적 근거 및 접근 통제 설계가 병행되어야 한다.
두 번째 과제는 데이터 기반 예측, 인과추론, 시뮬레이션을 결합한 정책모형 개발이다. 정책효과 분석은 단순 예측만으로 충분하지 않으며, 정책결정자는 특정 정책을 시행했을 때 발생할 반사실적 결과와 파급효과를 알고자 한다. 따라서 관측 데이터 기반 인과추론, 구조모형 기반 시뮬레이션, 기계학습 기반 예측모형을 결합하는 하이브리드 정책모형이 필요하다. 아울러 복수 모형의 결과가 상충할 때 이를 정책결정자에게 어떻게 제시할 것인지에 관한 방법론도 함께 요구된다.
세 번째 과제는 경제 디지털 트윈의 현실 동기화와 검증이다. 경제 디지털 트윈이 의미를 가지려면 경제구조, 산업연관, 가계‧기업 행동, 정부 재정, 금융부문, 국제거래 등의 변화가 데이터 기반으로 주기적으로 반영되어야 한다. 이를 위해 데이터 갱신주기, 모형 보정 방법, 시뮬레이션 검증 기준, 실제 관측 결과와 시뮬레이션 결과의 비교 체계가 필요하다. 또한 시뮬레이션 설정과 가정, 난수 조건을 기록하여 결과를 재현할 수 있게 하는 절차가 확립되어야 한다.
네 번째 과제는 검증 가능한 정책 에이전트와 오케스트레이션 기술이다. 에이전트가 어떤 데이터와 문서를 조회했는지, 어떤 모형을 호출했는지, 어떤 파라미터와 시나리오를 사용했는지, 어떤 중간 결과를 거쳐 최종 결과를 생성했는지 기록되어야 한다. 고위험 정책결정 지원 기능에는 인간 승인 지점, 자동 검증 규칙, 감사 로그, 롤백 기능, 권한 분리 구조가 필요하다.
다섯 번째 과제는 정책지능 평가 기준과 벤치마크 구축이다. 정책지능은 답변의 유창성보다 정책 문제 이해, 근거 정확성, 데이터 해석 능력, 법령‧제도 정합성, 예측 성능, 정책효과 분석의 타당성, 대안 비교의 일관성, 불확실성 설명, 감사 가능성이 중요하다. 따라서 정책 질의응답, 법령 근거 검색, 세수 전망, 정책효과 분석, 시나리오 생성, 정책보고서 작성 등 세부 과제별 벤치마크가 필요하다. 일반 목적 에이전트의 평가 방법론이 아직 정립 단계에 있다는 점[43]을 고려하면, 정책 도메인 벤치마크의 설계는 그 자체로 독립적인 연구과제에 해당한다.
여섯 번째 과제는 정책 AI 거버넌스와 주권형 공공 인프라 확립이다. 국내에서는 「인공지능 발전과 신뢰 기반 조성 등에 관한 기본법」이 인공지능의 건전한 발전과 신뢰 기반 조성을 위한 기본사항을 규정하고 있다[49]. 정책지능은 이러한 신뢰 기반 위에서 데이터, 모델, 시뮬레이션, 에이전트, 인간 정책결정자가 함께 작동하는 복합체계이므로, 책임 소재와 통제 구조를 명확히 해야 한다. 아울러 정책 실무자가 모형의 가정과 한계를 이해하고 산출물을 비판적으로 해석할 수 있는 역량 형성도 함께 추진되어야 한다.
VI. 결론
본고에서는 AI 주권과 AI 풀스택 경쟁이 확산되는 환경에서 국가 정책 의사결정을 지능화하기 위한 개념으로 정책지능을 정의하고, 이를 구현하기 위한 정책지능 참조 아키텍처(PIRA)를 제안하였다. AI 풀스택은 국가 AI 역량의 공급 기반이며, 공공 AX는 행정업무와 공공서비스 혁신을 촉진한다. 그러나 정책 의사결정은 다양한 정책 데이터와 제도적 제약, 미래 예측, 정책효과 분석, 근거 설명, 인간 책임성을 요구하므로, AI 풀스택과 공공 AX만으로 충분히 지원되기 어렵다. 또한, 정책지능은 정책분석학과 정책정보학, GovTech‧RegTech, 계산사회 과학과 사회 디지털 트윈 등 인접 개념과 문제의식을 공유하면서도, 정책과정 전반을 하나의 의사결정 아키텍처로 통합한다는 점에서 구별된다.
PIRA는 정책지능을 단일 AI 모델이나 개별 서비스가 아니라 핵심 역량, 기술 스택, 정책 업무 흐름 및 거버넌스가 결합된 통합 구조로 설명한다. 역량 관점은 정책 이해, 상황 인식, 미래 예측, 효과 분석‧시뮬레이션, 대안 생성‧평가, 근거 제시‧설명 및 실행 모니터링‧학습이라는 기능적 요구사항을 정의한다. 기술 스택 관점은 AI 인프라, 정책 데이터, 정책 지식, 정책 모델‧분석, 정책 시뮬레이션, 정책 에이전트 및 정책 서비스 계층을 제시한다. 업무 흐름 관점은 정책문제 인식부터 정책 집행 모니터링과 환류에 이르는 순환형 의사결정 절차를 설명한다. 거버넌스 관점은 인간 중심성, 책임성, 설명 가능성, 보안성, 공정성 및 AI 주권을 정책지능 운영 전반에 적용한다.
정책지능의 구현 기술은 LLM과 RAG, 지식그래프, 데이터 패브릭, 시계열 기반모델, 인과추론, 설명가능 AI, 디지털 트윈, 에이전트 기반 모델링, 강화학습, AI 에이전트, MLOps 및 AI 거버넌스 기술이 결합되는 방향으로 발전하고 있다. 중요한 것은 개별 기술의 도입 자체가 아니라, 정책 의사결정 과정에서 요구되는 역량을 중심으로 이러한 기술을 어떻게 연결하고 검증하며 운영할 것인가이다. 기술 동향 검토에서 확인된 공통점은 개별 요소기술의 성능 향상이 곧 정책적 활용 가능성으로 이어지지는 않는다는 점이다. 시계열 기반 모델은 벤치마크의 타당성 문제를, 인과 기계학습은 추정 과정의 투명성 문제를, 언어모델 기반 에이전트는 검증과 재현성 문제를 각각 남기고 있다. 이는 정책지능의 설계에서 정확도만이 아니라 가정의 명시, 불확실성의 제시, 산출 이력의 추적 가능성이 동등한 요구사항으로 다루어져야 함을 시사한다.
재정‧경제 분야는 정책지능의 대표 적용 영역이다. 세수 전망, 조세정책 효과분석, 재정지출 효과분석, 거시경제 충격 대응, AI 전환에 따른 노동시장‧ 재정정책 분석 등은 데이터 통합, 예측, 시뮬레이션, 대안 평가, 설명 가능성, 거버넌스가 모두 필요한 문제이다. 향후 정책지능 연구개발은 정책 특화 기반 모델, 데이터‧인과‧시뮬레이션 결합형 정책모형, 경제 디지털 트윈, 검증 가능한 정책 에이전트, 정책 지능 평가 벤치마크, 정책 AI 거버넌스, 주권형 정책 AI 인프라 구축을 중심으로 추진될 필요가 있다.
결론적으로, AI 주권 시대의 핵심 과제는 AI 기술을 보유하는 것에서 나아가 이를 국가 정책 의사결정 역량으로 전환하는 것이다. 본고가 제안한 PIRA는 범용 AI 풀스택을 정책 의사결정 지능으로 연결하는 개념적‧기술적 참조틀로서, 향후 공공부문 AI 연구개발과 정책지능 시스템 구축을 위한 공통 기준을 제공할 수 있다. 다만, PIRA는 특정 시스템의 구현 명세나 확정된 표준이 아니므로, 각 관점의 인터페이스와 구성요소 명세를 구체화하는 작업, 재정‧경제 이외의 정책영역에 대한 적용을 통한 일반성 검증, 실제 정책 업무 흐름에 결합한 시범 적용이 후속 과제로 남는다.
용어해설
AI 주권(AI Sovereignty) 국가가 AI 인프라, 데이터, 모델, 플랫폼 및 서비스의 핵심 요소를 자율적으로 확보·운영·통제할 수 있는 역량을 의미
AI 풀스택(AI Full Stack) AI 반도체, 컴퓨팅 인프라, 데이터, 기반모델, 플랫폼, 응용서비스를 포괄하는 AI 가치사슬 전반의 기술·산업 구조를 의미
정책지능(Policy Intelligence) 정책 데이터와 지식을 바탕으로 정책환경을 인식하고 미래를 예측하며 정책대안의 효과와 위험을 분석·설명하여 인간 정책결정자의 판단을 지원하는 AI 기반 의사결정 지능체계
PIRA(Policy Intelligence Reference Architecture) 정책지능을 핵심 역량, 기술 스택, 업무 흐름, 거버넌스 관점에서 설명하는 참조 아키텍처
RAG(Retrieval-Augmented Generation) 외부 지식 저장소에서 관련 문서를 검색한 뒤 이를 근거로 답변을 생성하는 접근
경제 디지털 트윈 현실 경제의 주체, 부문, 제도, 정책수단을 가상환경에 표현하고 실제 데이터와 지속적으로 연결하여 정책 시나리오를 실험하는 체계
Ministry of Science and ICT, "Korea’s Integrated AI Full Stack Cooperation Makes Official Debut in the Saudi Market," Press Release, 2026.
OECD/UNESCO, "G7 Toolkit for Artificial Intelligence in the Public Sector," OECD Publishing, Paris, 2024. doi: 10.1787/421c1244-en
OECD, "Adopting and Governing AI in Government," in Digital Government Outlook 2026: From Foundations to Transformational Impact, OECD Publishing, Paris, 2026. doi: 10.1787/0496b2bc-en
OECD, "Trends and Early Lessons from the Use of AI Across Functions of Government," in Governing with Artificial Intelligence: The State of Play and Way Forward in Core Government Functions, OECD Publishing, Paris, 2025. doi: 10.1787/795de142-en
NIST, Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1, 2023. doi: 10.6028/NIST.AI.100-1
J.R. Gil-Garcia et al., "Policy Analytics, Modelling, and Informatics: Innovative Tools for Solving Complex Social Problems," Springer, 2018. doi: 10.1007/978-3-319-61762-6
N. Bharosa, "The Rise of GovTech: Trojan Horse or Blessing in Disguise? A Research Agenda," Gov. Inf. Q., vol. 39, no. 3, 2022, Article no. 101692. doi: 10.1016/j.giq.2022.101692
D. Lazer et al., "Computational Social Science," Science, vol. 323, no. 5915, 2009, pp. 721-723. doi: 10.1126/science.1167742
A. Chircu et al., "Towards a Digital Twin of Society," in Proc. 56th Hawaii Int. Conf. Syst. Sci., (Maui, HI, USA), Jan. 2023. doi: 10.24251/HICSS.2023.816
Z. Engin et al., "The Algorithmic State Architecture (ASA): An Integrated Framework for AI-Enabled Government," arXiv preprint, 2025. doi: 10.48550/arXiv.2503.08725
ISO/IEC/IEEE, ISO/IEC/IEEE 42010:2022, Software, Systems and Enterprise—Architecture Description, 2022.
R. Cloutier et al., "The Concept of Reference Architectures," Syst. Eng., vol. 13, no. 1, 2010, pp. 14-27. doi: 10.1002/sys.20129
M. Howlett et al., "Studying Public Policy: Policy Cycles and Policy Subsystems," 3rd ed., Oxford University Press, 2009.
M.D. Wilkinson et al., "The FAIR Guiding Principles for Scientific Data Management and Stewardship," Sci. Data, vol. 3, 2016, Article no. 160018. doi: 10.1038/sdata.2016.18
A. Hogan et al., "Knowledge Graphs," ACM Comput. Surv., vol. 54, no. 4, 2021, Article no. 71. doi: 10.1145/3447772
P. Lewis et al., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks," in Proc. Adv. Neural Inf. Process. Syst., Virtual Conf., 2020, pp. 9459-9474.
Y. Gao et al., "Retrieval-Augmented Generation for Large Language Models: A Survey," arXiv preprint, 2024. doi: 10.48550/arXiv.2312.10997
D. Edge et al., "From Local to Global: A Graph RAG Approach to Query-Focused Summarization," arXiv preprint, 2024. doi: 10.48550/arXiv.2404.16130
Y. Liang et al., "Foundation Models for Time Series Analysis: A Tutorial and Survey," in Proc. ACM SIGKDD Conf. Knowl. Discov. Data Min., (Barcelona, Spain), Aug. 2024. doi: 10.1145/3637528.3671451
A. Das et al., "A Decoder-Only Foundation Model for Time-Series Forecasting," in Proc. Int. Conf. Mach. Learn., (Vienna, Austria), July 2024.
A.F. Ansari et al., "Chronos: Learning the Language of Time Series," Trans. Mach. Learn. Res., 2024.
M. Meyer et al., "Rethinking Evaluation in the Era of Time Series Foundation Models: (Un)known Information Leakage Challenges," arXiv preprint, 2025. doi: 10.48550/arXiv.2510.13654
K. Akepanidtaworn and K. Akepanidtaworn, "GDP Nowcasting Performance of Traditional Econometric Models vs Machine-Learning Algorithms: Simulation and Case Studies," IMF Working Paper, no. WP/25/252, 2025. doi: 10.5089/9798229033626.001
J. Pearl, "Causal Inference in Statistics: An Overview," Stat. Surv., vol. 3, 2009, pp. 96-146. doi: 10.1214/09-SS057
V. Chernozhukov et al., "Double/Debiased Machine Learning for Treatment and Structural Parameters," Econom. J., vol. 21, no. 1, 2018, pp. C1-C68. doi: 10.1111/ectj.12097
S. Wager and S. Athey, "Estimation and Inference of Heterogeneous Treatment Effects using Random Forests," J. Am. Stat. Assoc., vol. 113, no. 523, 2018, pp. 1228-1242. doi: 10.1080/01621459.2017.1319839
P. Rehill, "Transparency Challenges in Policy Evaluation with Causal Machine Learning: Improving Usability and Accountability," Data & Policy, vol. 6, 2024, Article no. e43.
S.M. Lundberg and S.I. Lee, "A Unified Approach to Interpreting Model Predictions," in Proc. Adv. Neural Inf. Process. Syst., (Long Beach, CA, USA), Dec. 2017.
C. Rudin, "Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Instead," Nat. Mach. Intell., vol. 1, 2019, pp. 206-215. doi: 10.1038/s42256-019-0048-x
F. Emmert-Streib, "Defining a Digital Twin: A Data Science-Based Unification," Mach. Learn. Knowl. Extr., vol. 5, no. 3, 2023, pp. 1036-1054. doi: 10.3390/make5030054
S. Poledna et al., "Economic Forecasting with an Agent-Based Model," Eur. Econ. Rev., vol. 151, 2023, Article no. 104306. doi: 10.1016/j.euroecorev.2022.104306
H. Sutherland and F. Figari, "EUROMOD: The European Union Tax-Benefit Microsimulation Model," Int. J. Microsimul., vol. 6, no. 1, 2013, pp. 4-26.
S. Zheng et al., "The AI Economist: Taxation Policy Design via Two-Level Deep Multiagent Reinforcement Learning," Sci. Adv., vol. 8, no. 18, 2022, Article no. eabk2607. doi: 10.1126/sciadv.abk2607
S. Yao et al., "ReAct: Synergizing Reasoning and Acting in Language Models," in Proc. Int. Conf. Learn. Represent., (Kigali, Rwanda), May 2023.
T. Schick et al., "Toolformer: Language Models Can Teach Themselves to Use Tools," in Proc. Adv. Neural Inf. Process. Syst., (New Orleans, LA, USA), Dec. 2023.
J.S. Park et al., "Generative Agents: Interactive Simulacra of Human Behavior," in Proc. ACM Symp. User Interface Softw. Technol., (San Francisco, CA, USA), Oct. 2023. doi: 10.1145/3586183.3606763
A. Yehudai et al., "A Survey on Evaluation of LLM-based Agents," arXiv preprint, 2025. doi: 10.48550/arXiv.2503.16416
C. Dwork and A. Roth, "The Algorithmic Foundations of Differential Privacy," Found. Trends Theor. Comput. Sci., vol. 9, no. 3-4, 2014, pp. 211-407. doi: 10.1561/0400000042
S. Ruggles et al., "Differential Privacy and Census Data: Implications for Social and Economic Research," AEA Pap. Proc., vol. 109, 2019, pp. 403-408. doi: 10.1257/pandp.20191107
E. Dabla-Norris and R. de Mooij, "Fiscal Policy Can Help Broaden the Gains of AI to Humanity," IMF Blog, 2024.
BIS, "Artificial Intelligence and the Economy: Implications for Central Banks," in Annual Economic Report 2024, Bank for International Settlements, 2024.
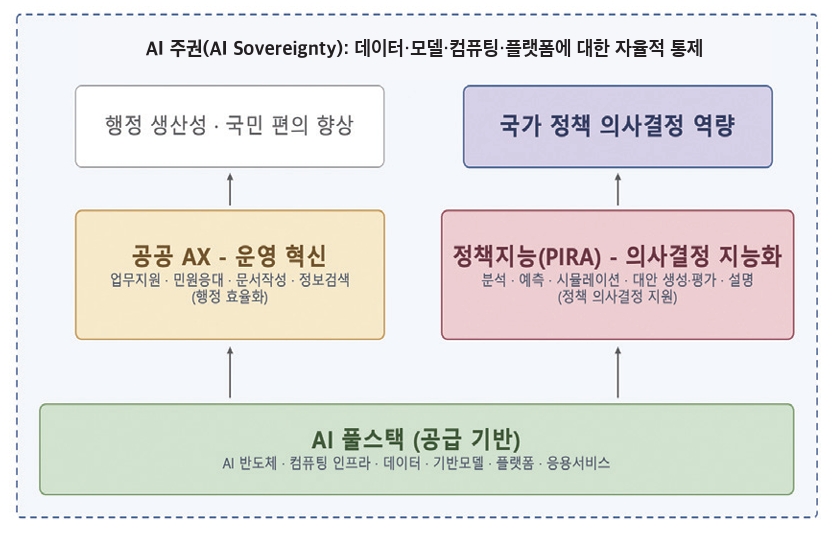
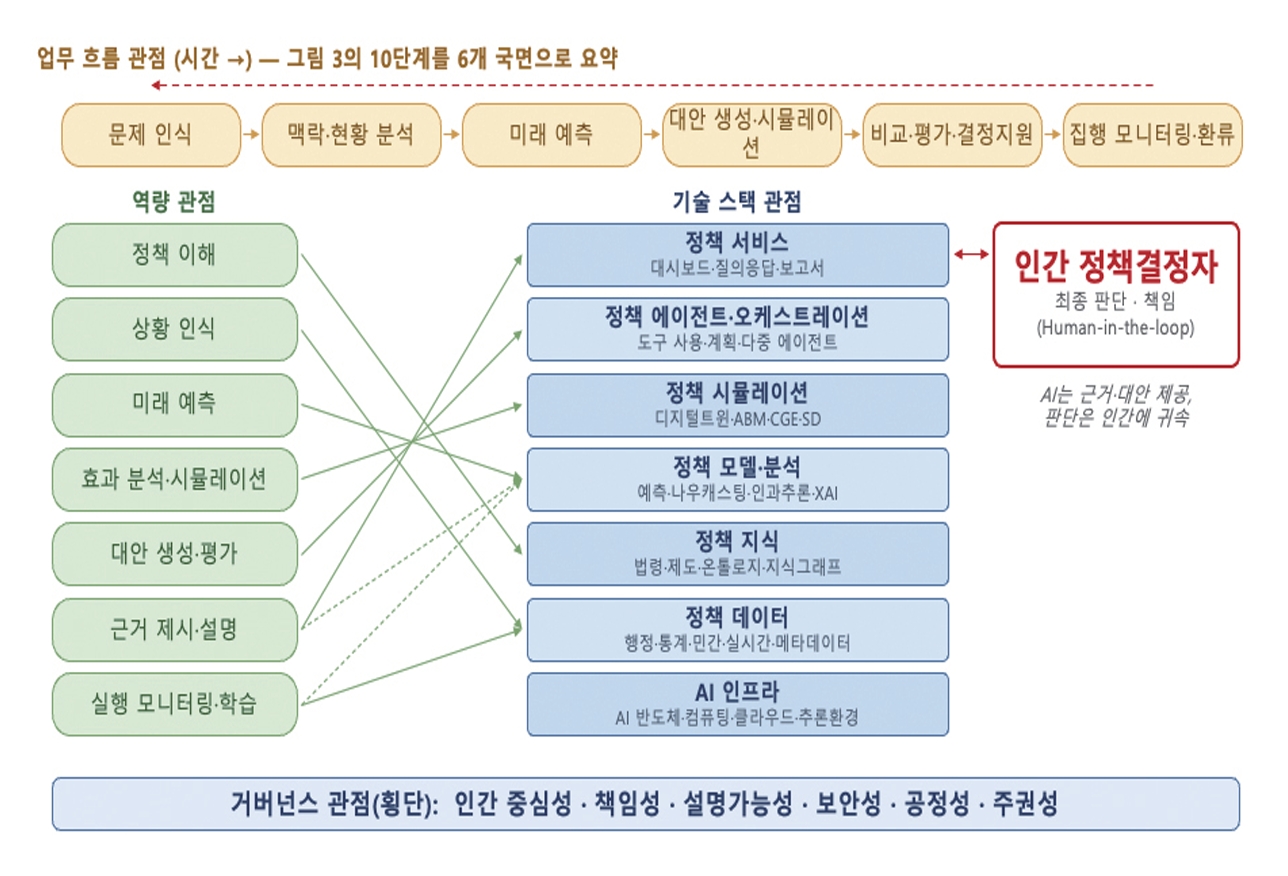
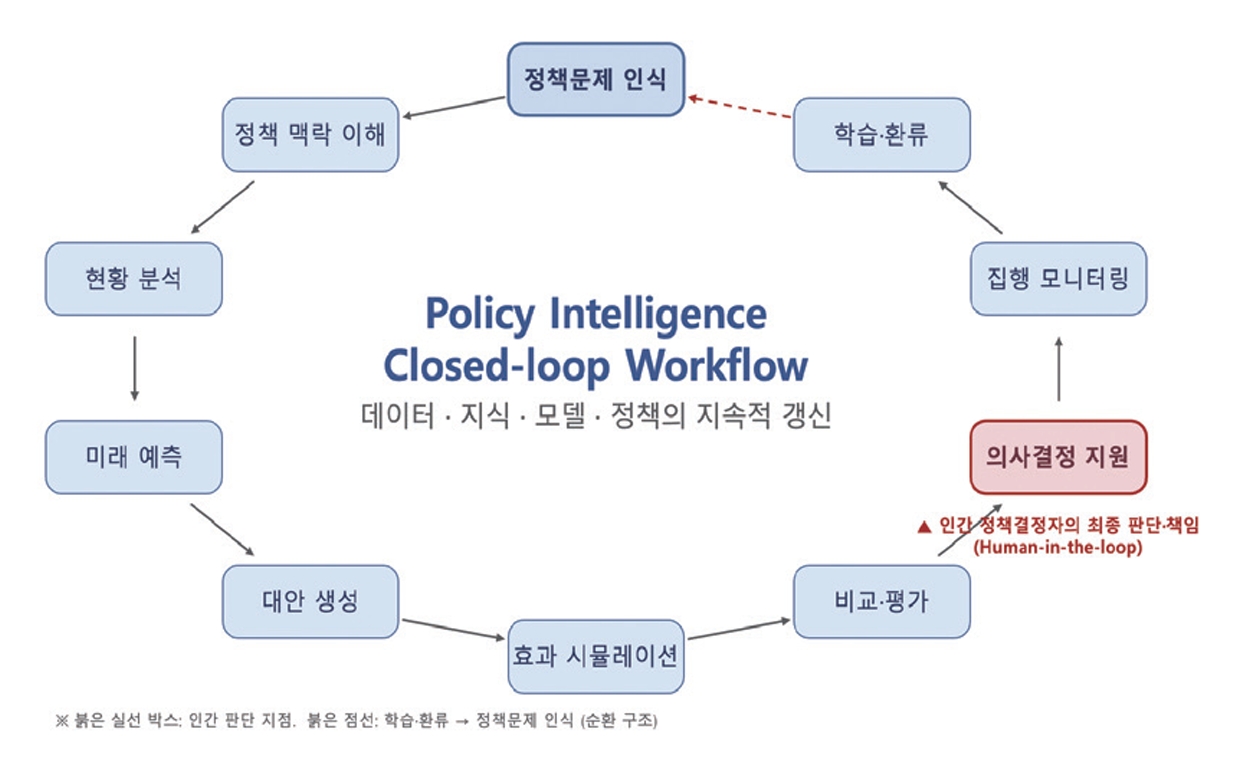
표 1 정책지능 핵심 역량과 관련 기술
표 2 PIRA의 기술 스택 계층
표 3 PIRA 기반 재정·경제 정책지능 구성
- Sign Up
- 전자통신동향분석 이메일 전자저널 구독을 원하시는 경우 정확한 이메일 주소를 입력하시기 바랍니다.